統計モデリング入門 2023 岩手連大
(Graduate School of Life Sciences, Tohoku University)
https://heavywatal.github.io/slides/iwate2023stats/
データを使ってやりたいこと
- 現象を理解したい
- 将来を予測したい
- ものを分類・判別したい
- 挙動を制御したい
- 新しい何かを生成したい
そのために解析は必要? 未加工の生データこそ宝?
データ解析って必要? 生データ見ればいいべ?
往々にして複雑過ぎ、情報多すぎ、そのままでは手に負えない
print(ggplot2::diamonds)
      carat       cut color clarity depth table price    x    y    z
    1  0.23     Ideal     E     SI2  61.5    55   326 3.95 3.98 2.43
    2  0.21   Premium     E     SI1  59.8    61   326 3.89 3.84 2.31
    3  0.23      Good     E     VS1  56.9    65   327 4.05 4.07 2.31
    4  0.29   Premium     I     VS2  62.4    58   334 4.20 4.23 2.63
   --
53937  0.72      Good     D     SI1  63.1    55  2757 5.69 5.75 3.61
53938  0.70 Very Good     D     SI1  62.8    60  2757 5.66 5.68 3.56
53939  0.86   Premium     H     SI2  61.0    58  2757 6.15 6.12 3.74
53940  0.75     Ideal     D     SI2  62.2    55  2757 5.83 5.87 3.64
ダイヤモンド53,940個について10項目の値を持つデータセット
要約統計量を見てみよう
各列の平均とか標準偏差とか:
  stat carat depth table    price
1 mean  0.80 61.75 57.46  3932.80
2   sd  0.47  1.43  2.23  3989.44
3  max  5.01 79.00 95.00 18823.00
4  min  0.20 43.00 43.00   326.00
大きさ carat と価格 price の相関係数はかなり高い:
      carat depth table price
carat  1.00
depth  0.03  1.00
table  0.18 -0.30  1.00
price  0.92 -0.01  0.13  1.00
生のままよりは把握しやすいかも。
分布を特徴づける代表値 central tendency
- 平均値 mean
- 和を観察数で割る
- 中央値 median
- 順に並べて真ん中
- 最頻値 mode
- 最も頻度が高い値
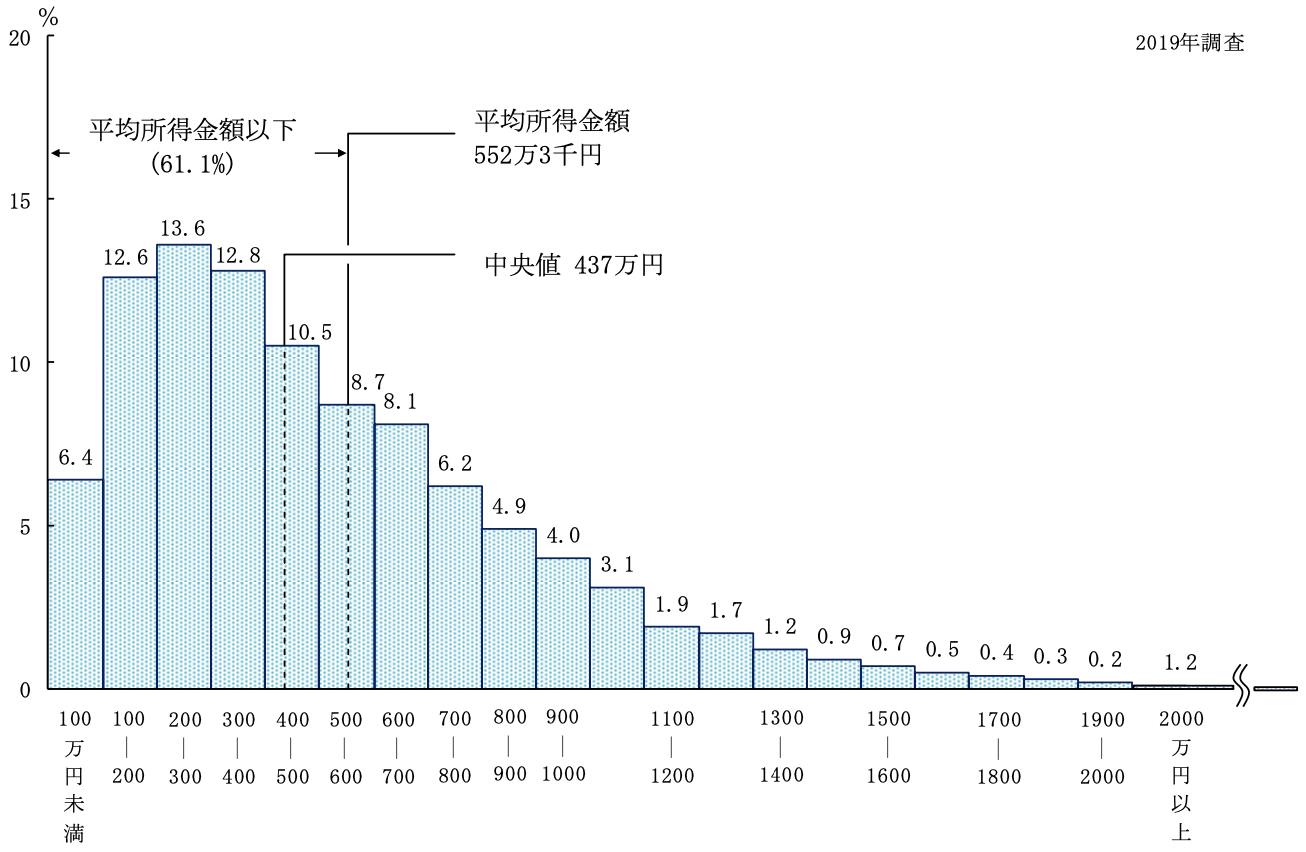
目的や状況に応じて使い分けよう。
- 外れ値に対する応答
- もし総資産額20兆円の大富豪が鳥取県に引っ越してきたら
→ 県民の平均資産は4000万円上昇。中央値・最頻値はほぼそのまま。
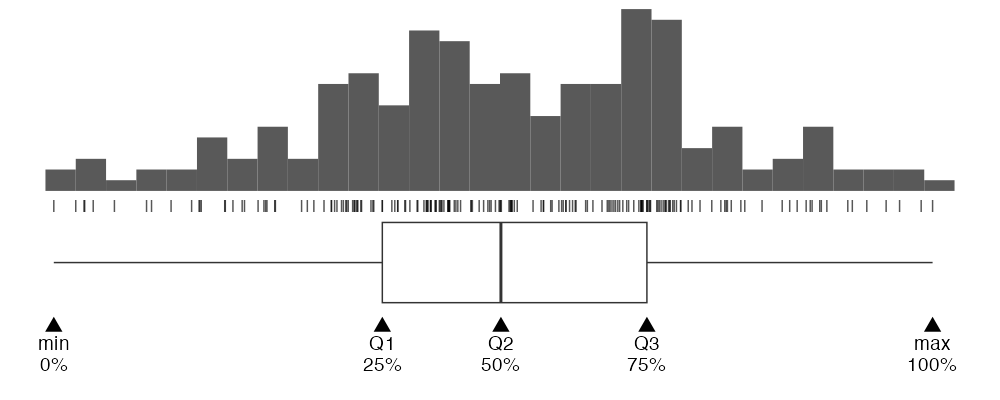
ばらつきを捉える記述統計量
- 分散 variance
- 平均値からの差の自乗の平均。 $\frac 1 n \sum _i ^n (X_i - \bar X)^2$
- これの平方根が標準偏差 (standard deviation)。
- Percentile, Quantile (四分位)
- 小さい順にならべて上位何%にあるか。
- 中央値 = 50th percentile = 第二四分位(Q2)
ばらつきの様子は大小の判断にも重要
たまたまかも。
Bが高いのもたまたま?
AとBには差がありそう。
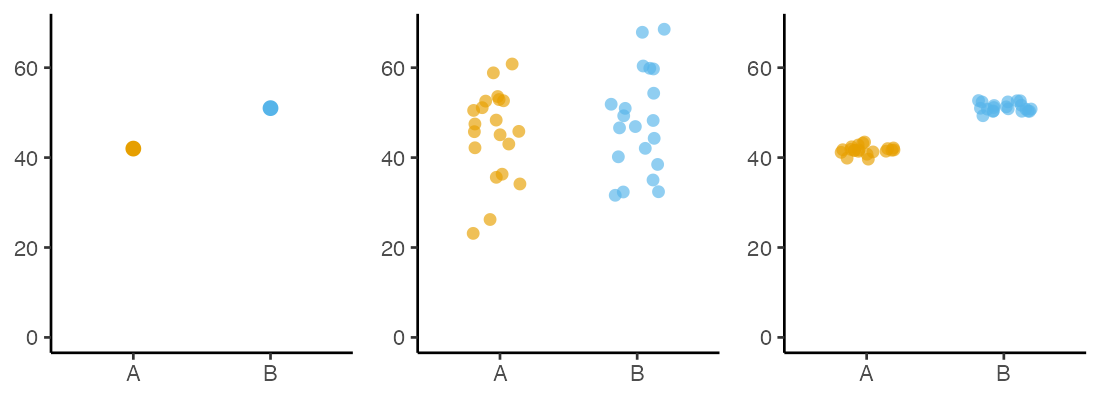
「こんなことがたまたま起こる確率はすごく低いです!」
をちゃんと示す手続きが統計的仮説検定。
記述統計量に頼りすぎず分布を可視化する
同じデータでも見せ方で印象・情報量が変わる。
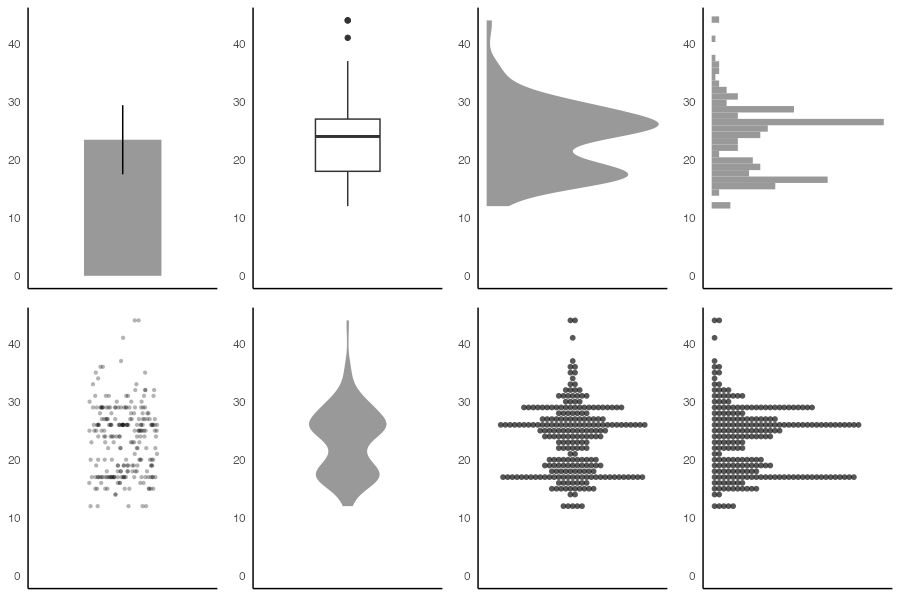
代表値ばかり見て可視化を怠ると構造を見逃す
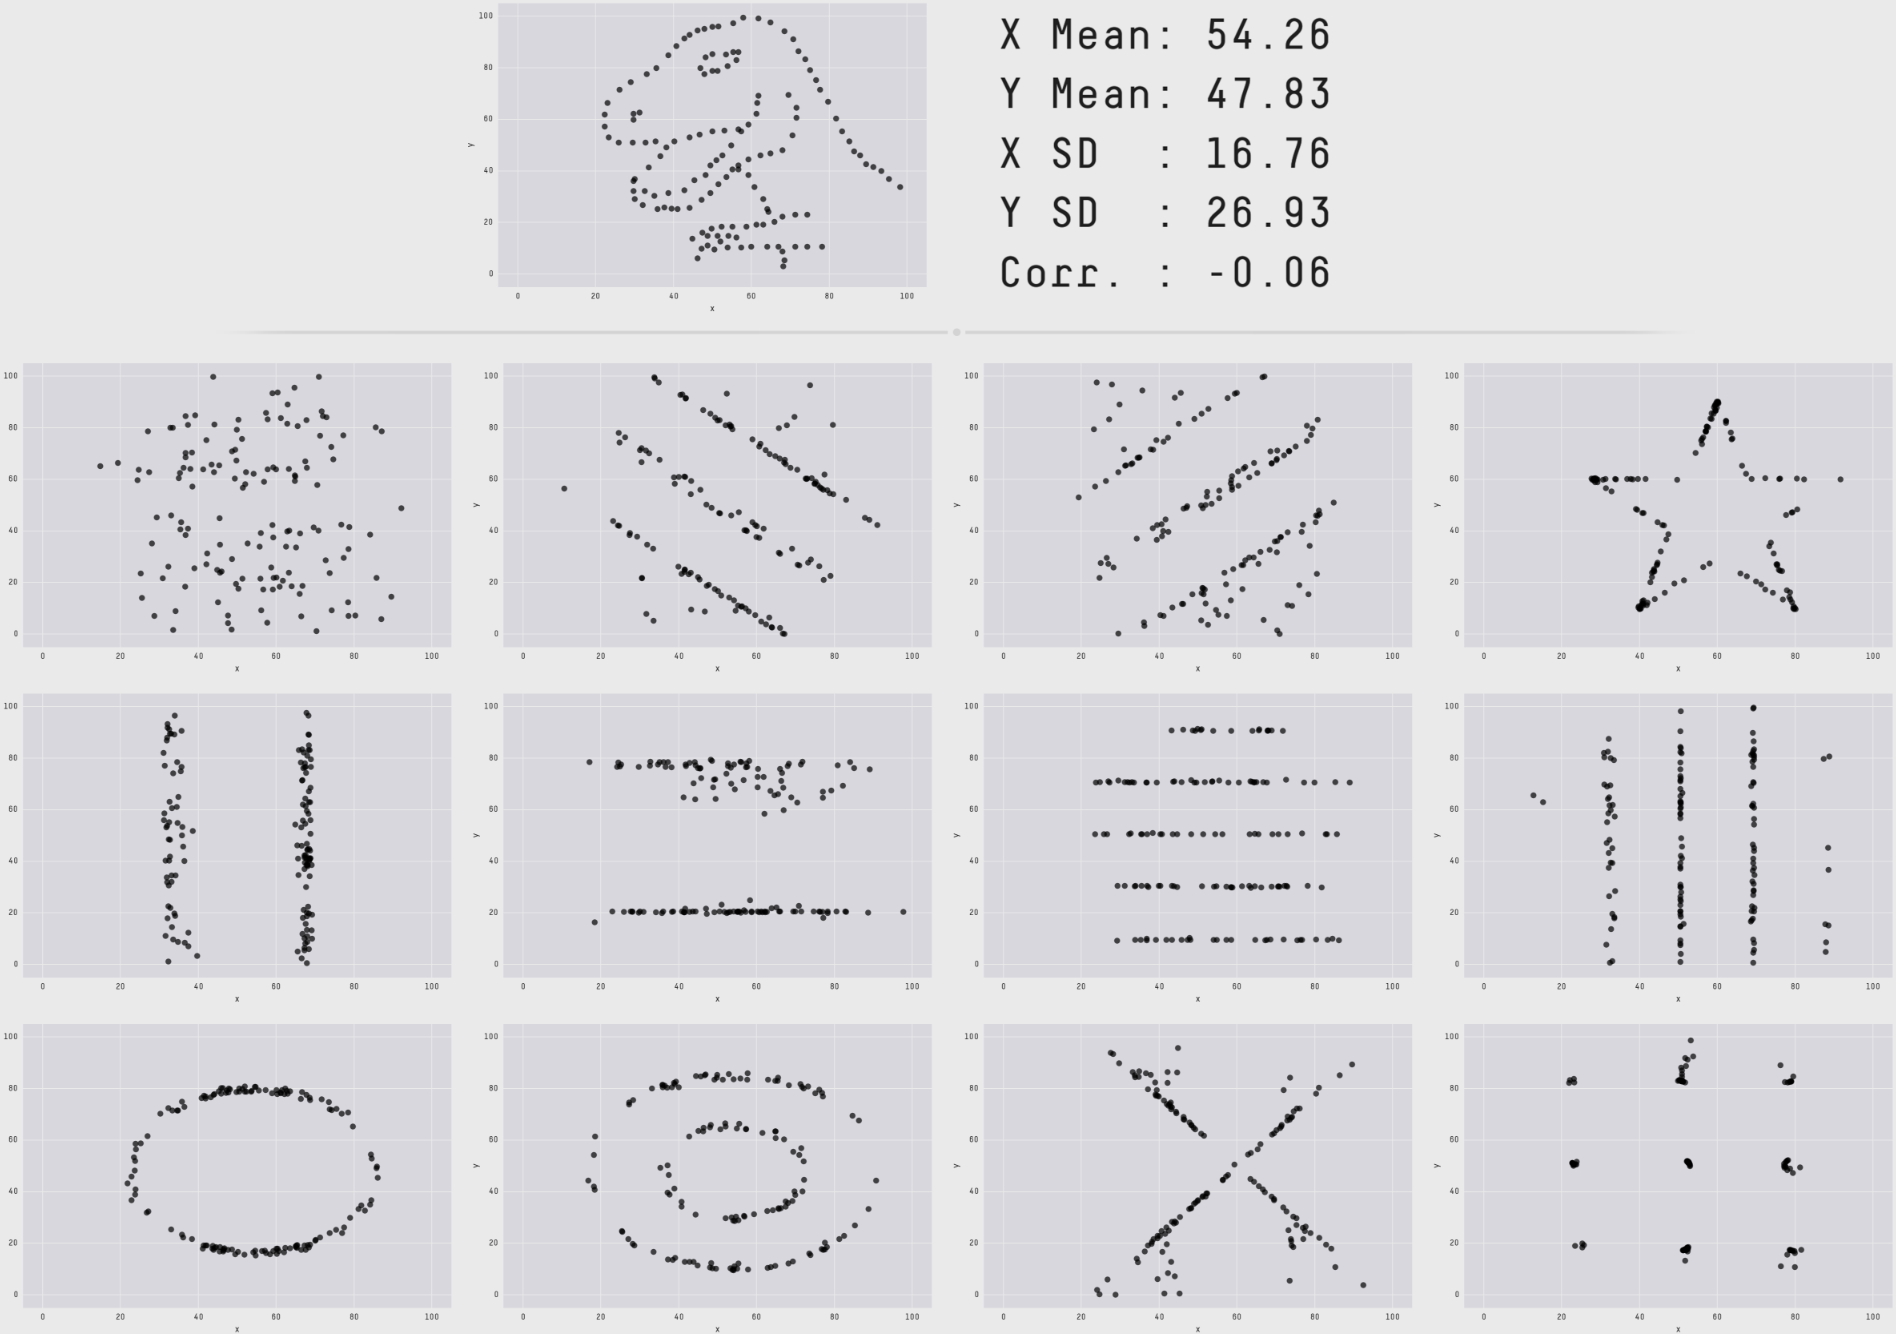
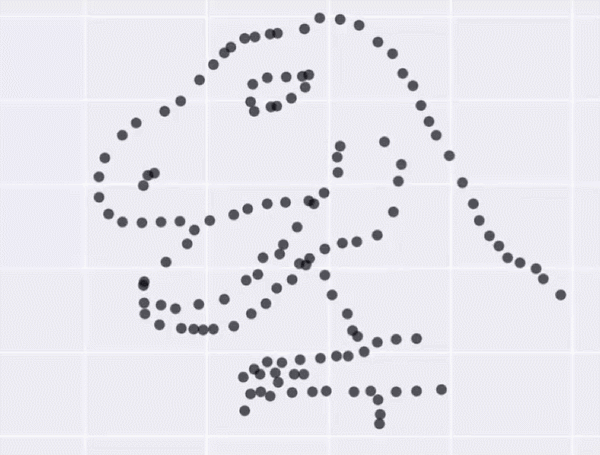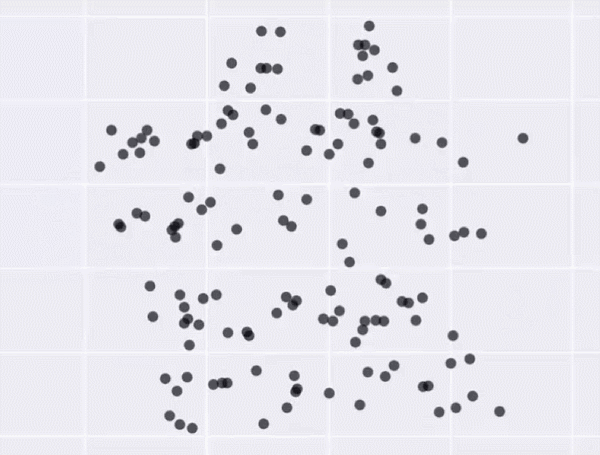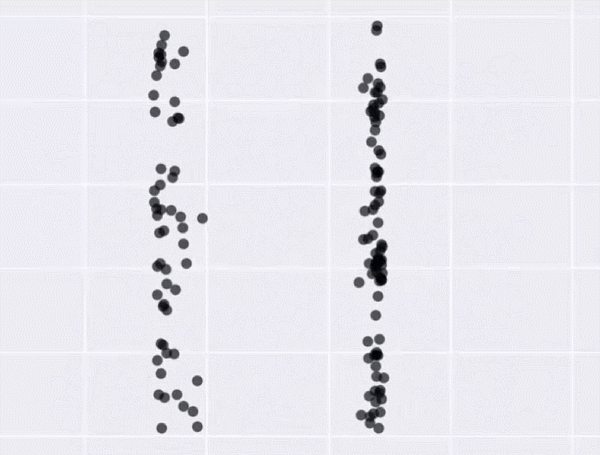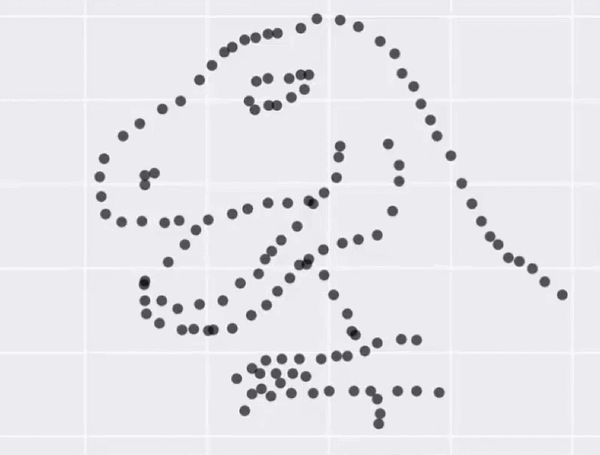
データ可視化は理解の第一歩
情報をうまく絞って整理 → 直感的にわかる
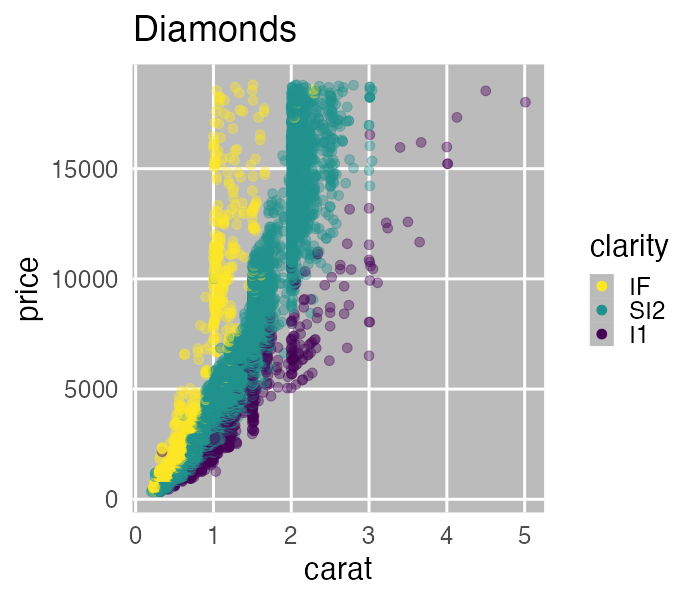
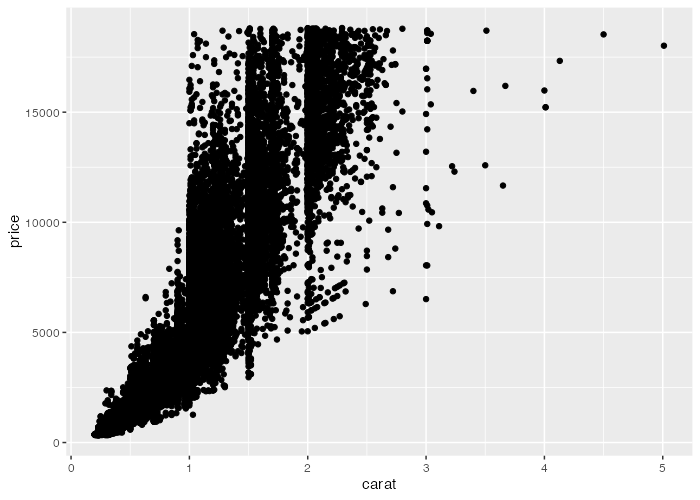
carat が大きいほど price も高いらしい。
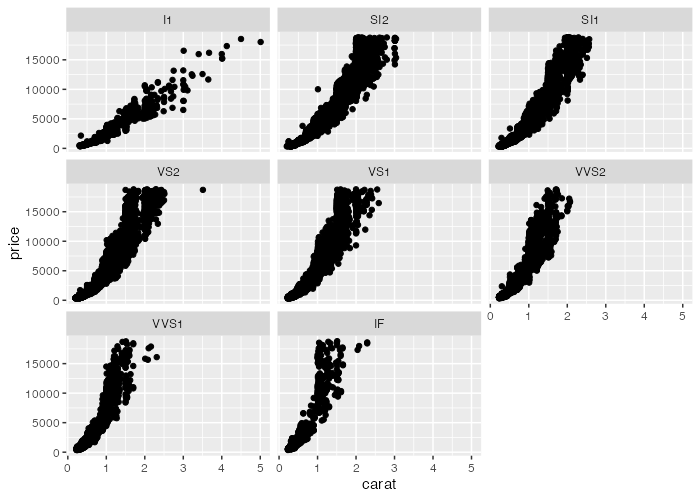
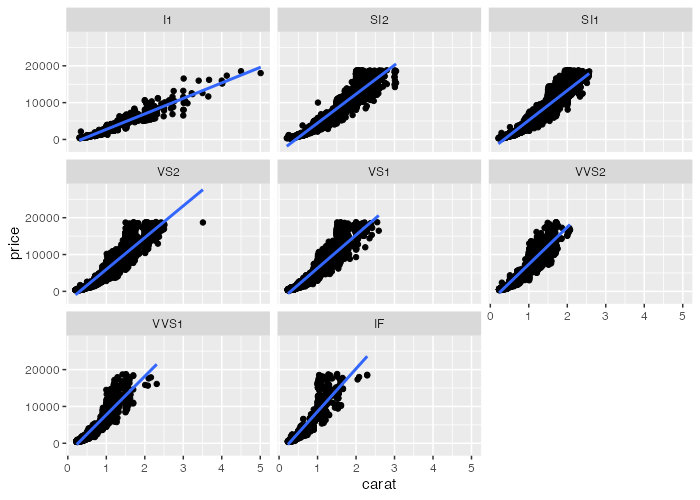
その度合いは clarity によって異なるらしい。
統計とは
データをうまくまとめ、それに基づいて推論するための手法。
- 記述統計: データそのものを要約する
- 要約統計量 (e.g., 平均、標準偏差、etc.)
- 作図、作表
- 推測統計: データの背後にある母集団・生成過程を考える
- 数理モデル
- 確率分布
- パラメータ(母数)
「グラフを眺めてなんとなく分かる」以上の分析にはモデルが必要
モデルとは
対象システムを単純化・理想化して扱いやすくしたもの
- Mathematical Model 数理モデル
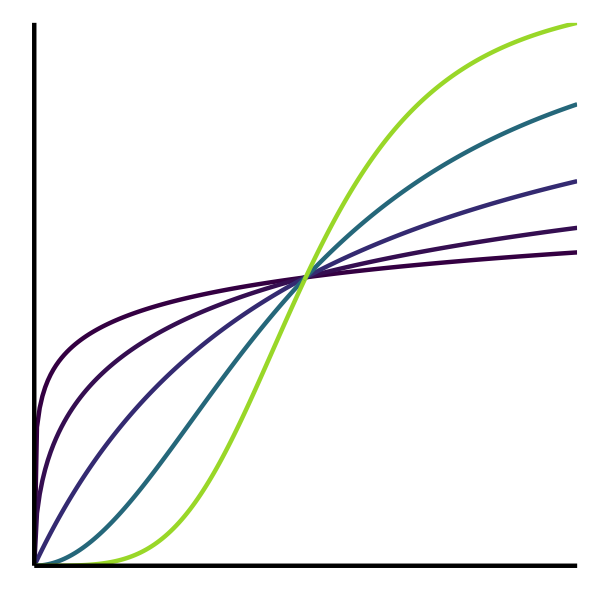
- 数学的な方程式として記述されるもの。
- e.g., Lotka-Volterra eq., Hill eq.
- Computational Model 数値計算モデル
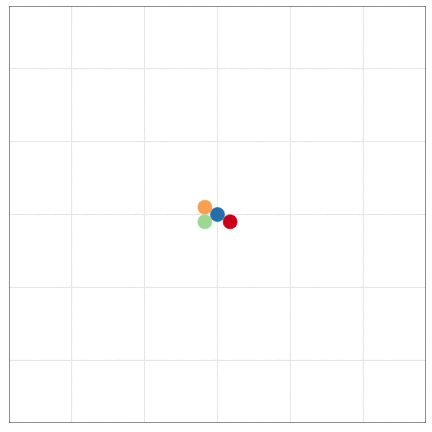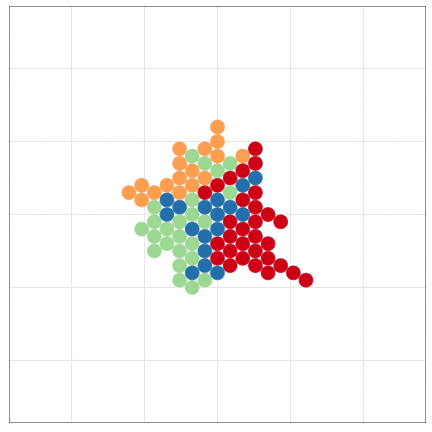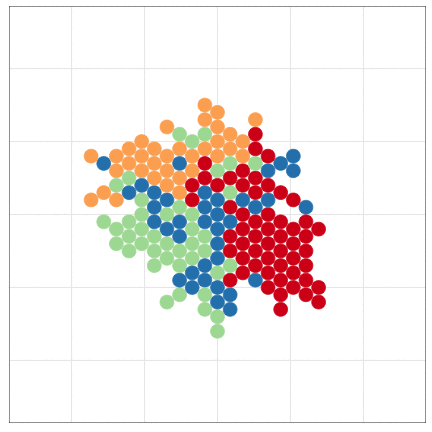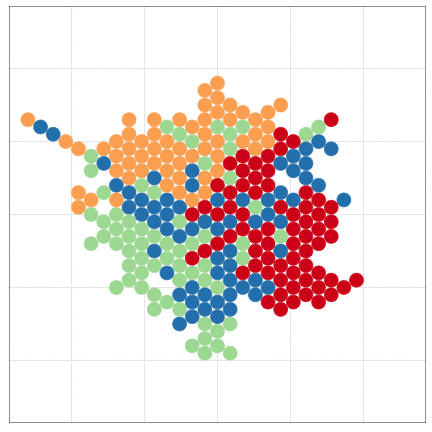
- 数値計算の手続きとして記述されるもの。
- e.g., Schelling’s Segregation Model, tumopp
- Concrete Model 具象モデル
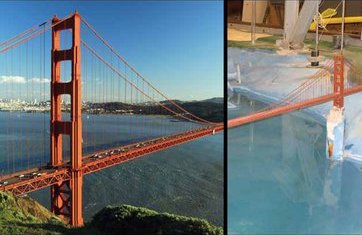
- 具体的な事物で作られるもの。
- e.g., San Francisco Bay-Delta Model
データ科学における数理モデル
データ生成をうまく真似できそうな仮定の数式表現。

データ科学における数理モデル
データ生成をうまく真似できそうな仮定の数式表現。
e.g., 大きいほど高く売れる: $\text{price} = A \times \text{carat} + B + \epsilon$
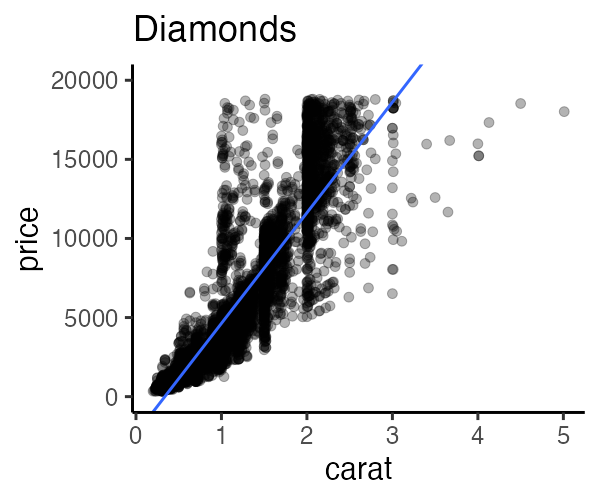
新しく採れたダイヤモンドの価格予想とかにも使える。
このように「YをXの関数として表す」ようなモデルを回帰と呼ぶ。
本講義の主題: 回帰
単純な直線あてはめから出発し、ちょっとずつ統計モデリング。
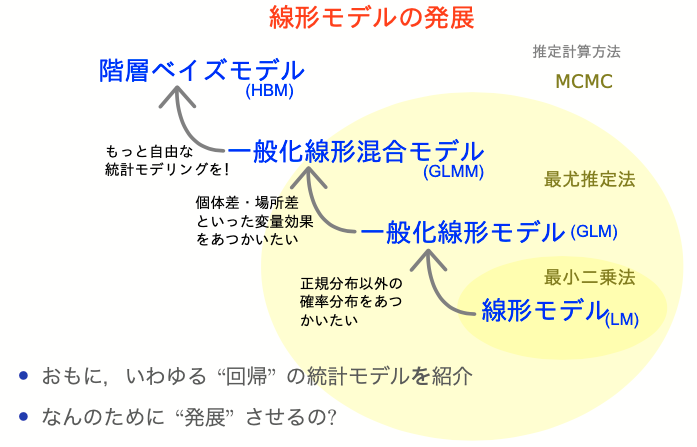
何でもかんでも直線あてはめではよろしくない
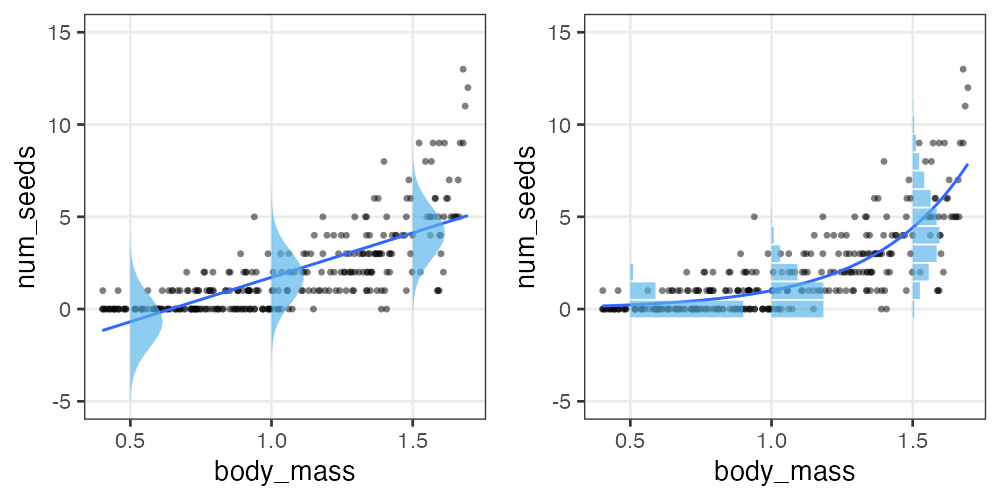
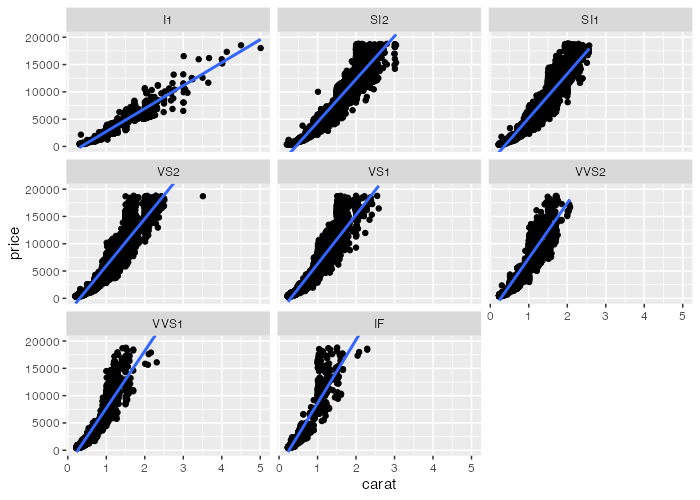
- 観察データは常に正の値なのに予測が負に突入してない?
- 縦軸は整数。しかものばらつきが横軸に応じて変化?
- データに合わせた統計モデルを使うとマシ
回帰は教師あり機械学習の一種とも言える

でも統計モデリングはいわゆる“機械学習”とは違う気もする…?
モデリングにおける2つのアプローチ

どっちも知っておいて使い分けたい
| 項目 | 統計モデリング | 近年の機械学習 |
|---|---|---|
| モデル構造 | 単純化したい | 性能のためなら複雑化 |
| モデル解釈 | ここが強み | 難しい。重視しない。途上。 |
| 予測・生成 | うまくすれば頑健 | 主目的。強力。高精度 |
| データ量 | 少なくてもそれなり | 大量に必要 |
| 計算量 | 場合による | 場合による |
| 例 | 一般化線形モデル 階層ベイズモデル |
ランダムフォレスト ニューラルネットワーク |
教科書的には概ねこんな感じとして、実際の仕事ではどうだろう?
現役データサイエンティスト2人に聞きました
- 統計モデルはデータ加工など事前の手続きが多め。
機械学習は事前の決定が少ないので楽ちん。 - 「要因の効果はどれくらい?」
意思決定をするのは結局人間。物事を分かった上で判断したい。
実務の人への説明や意思決定の場面で解析の解釈性が重要。 - 仮説があるなら、それに基づいて統計モデリング。
何もないところからまず機械学習で要因抽出・仮説生成するのもあり。 - 統計モデル縛り・実行環境縛りなどの案件もある。
- 分析方針を決める立場の上級職になるつもりなら統計モデルも必要。
協力: @kato_kohakuさん、@teuderさん
本講義のお品書き
久保先生の"緑本"こと
「データ解析のための統計モデリング入門」
をベースに回帰分析の概要を紹介。
- イントロ 👈 いまここ
- Rの基礎を駆け足で
- 統計モデルの基本
- 直線回帰
- 確率変数・確率分布 👈 次回の主役
- 尤度・最尤推定
- 一般化線形モデル、混合モデル
- ベイズ統計(、階層ベイズモデル)
Rとは
統計解析と作図の機能が充実したプログラミング言語・環境

- クロスプラットフォーム
- Linux, Mac, Windows で動く
- オープンソース
- 永久に無償で、すべての機能を使える。
- 集合知によって常に進化している。
- コミュニティ
- 相談できる人や参考になるウェブサイトがたくさん見つかる。
R環境のセットアップ
- R本体
- コマンドを解釈して実行するコア部分。
- よく使われる関数なども標準パッケージとして同梱。
- RStudio Desktop
- Rをより快適に使うための総合開発環境 (IDE)
- 必須じゃないけど便利なので結構みんな使ってる。
- ライバルは VSCode + R Extention (私はこちらを使用)
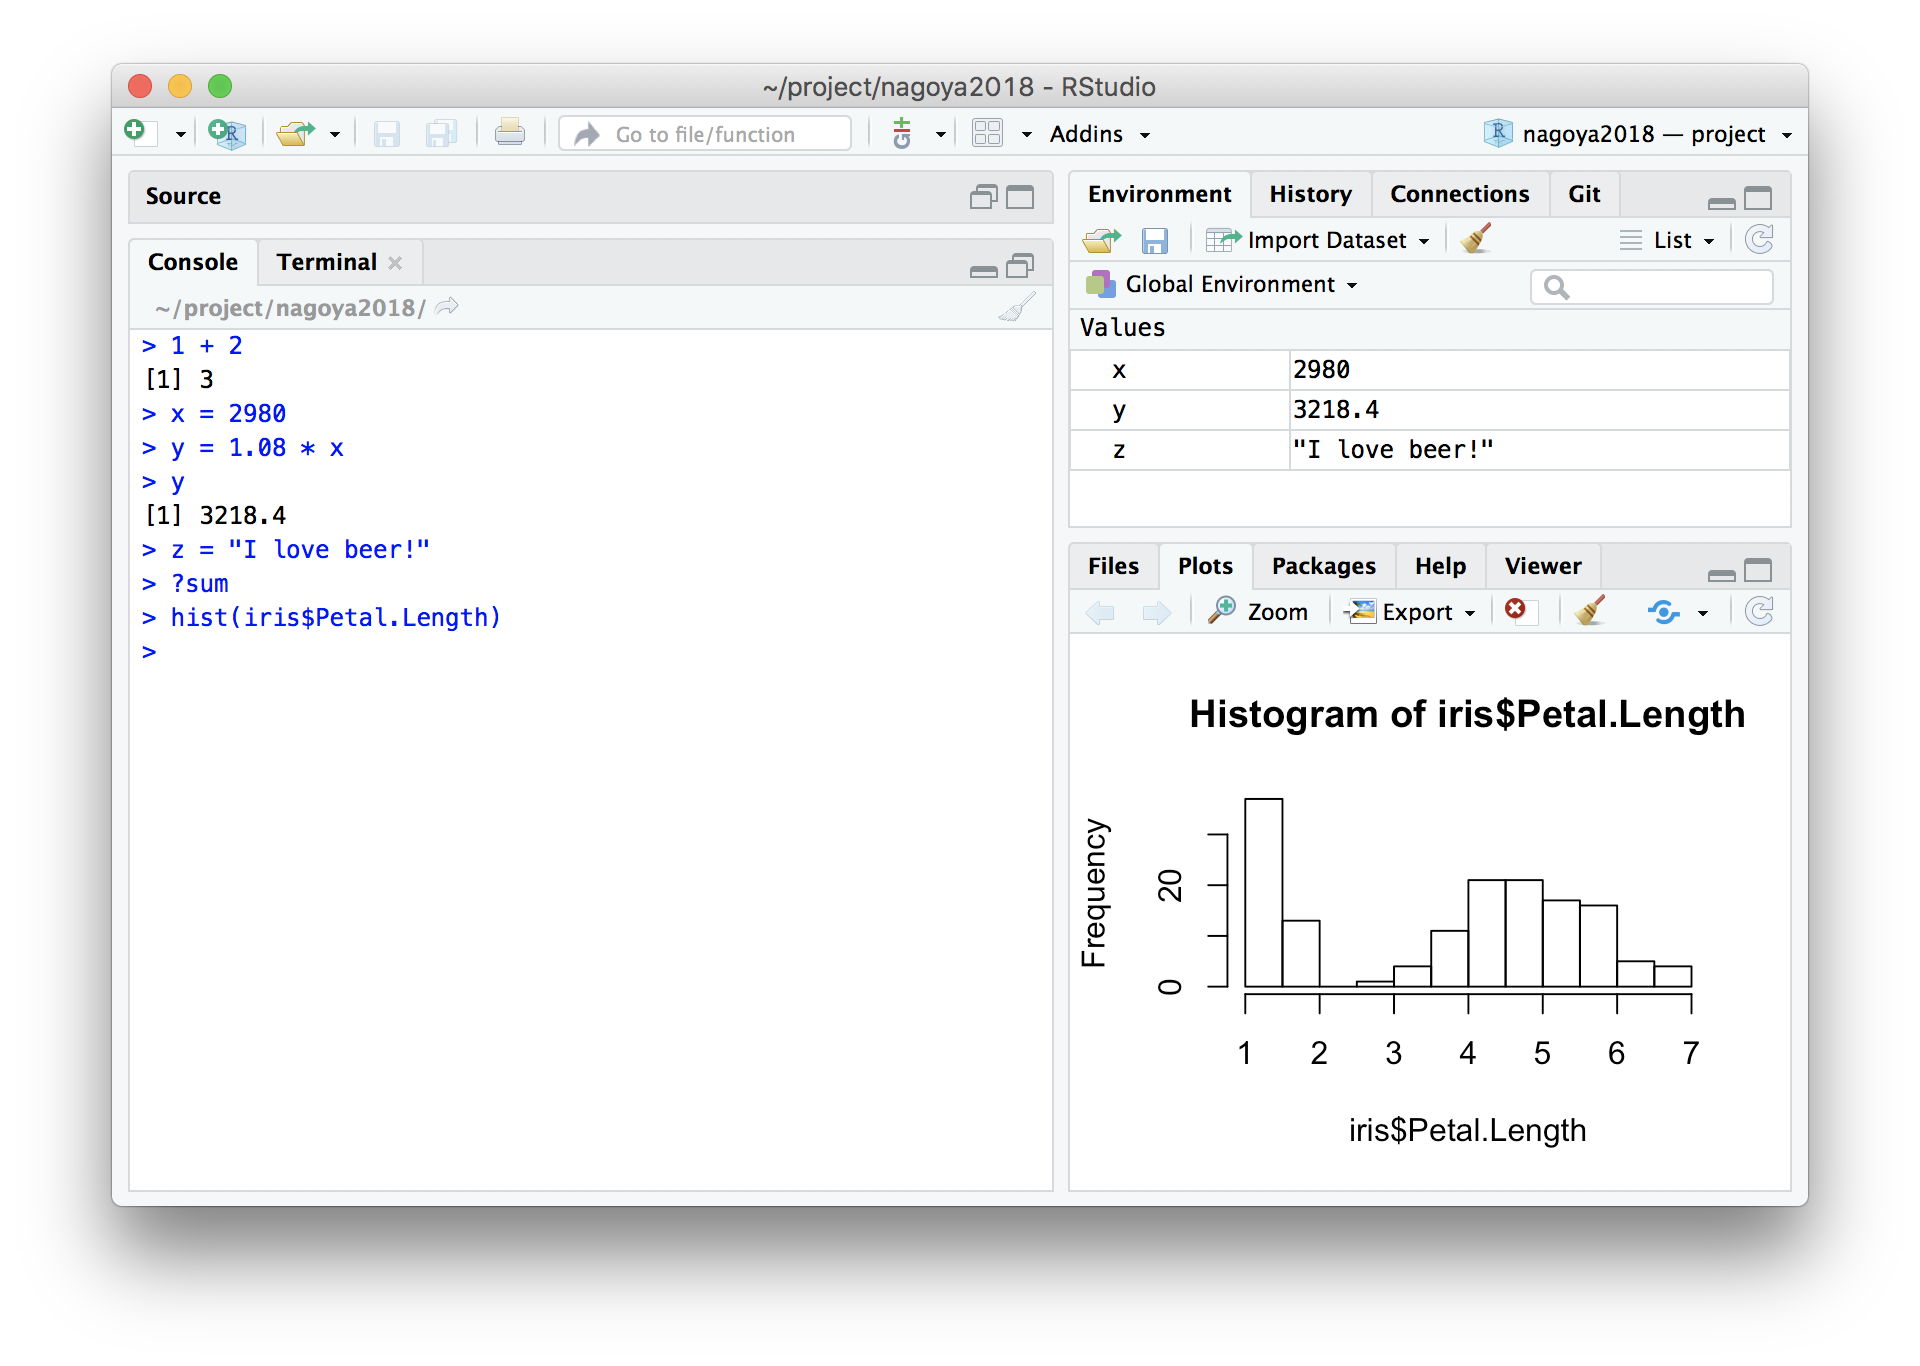
RStudioを起動してConsoleで対話しよう
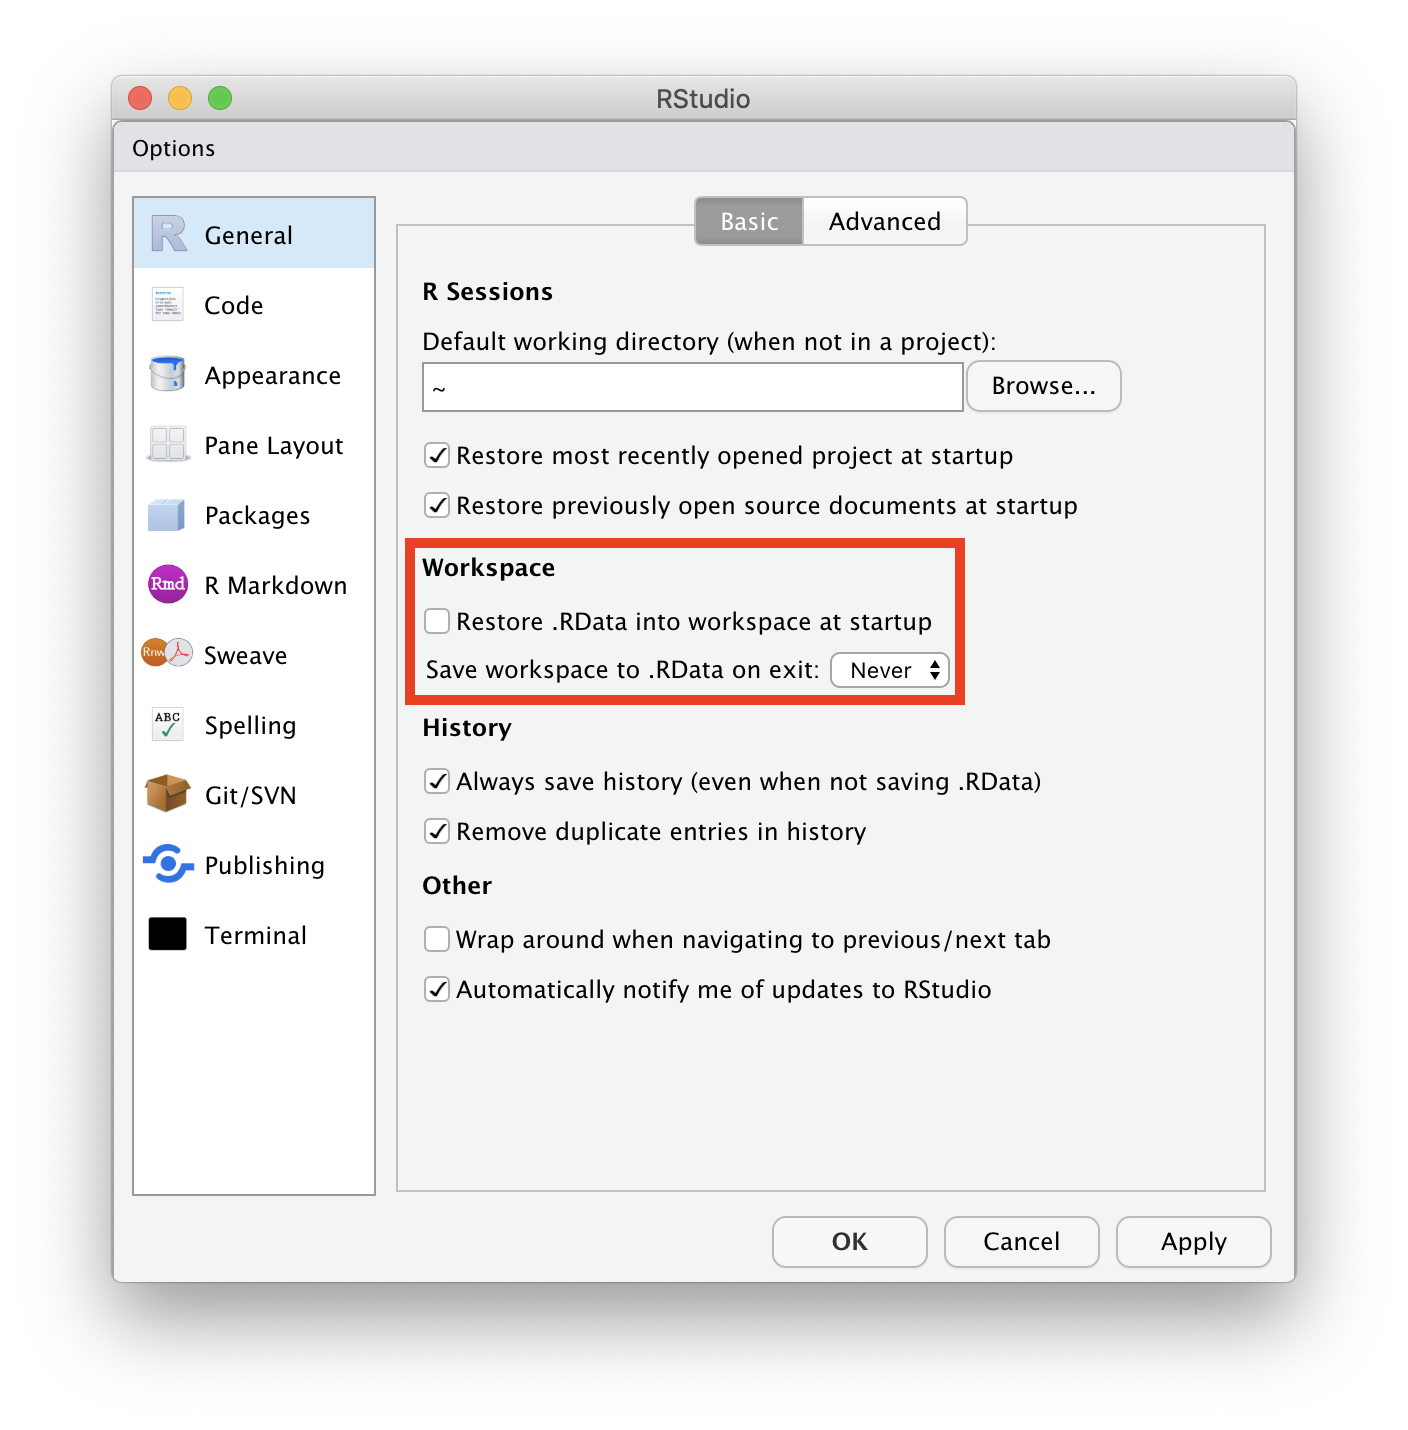
Workspace (Environment) = 一時オブジェクトの集まり
毎回まっさらなワークスペースで始める設定
“Restore …” のチェックを外して、 “Save …” のNeverを選択
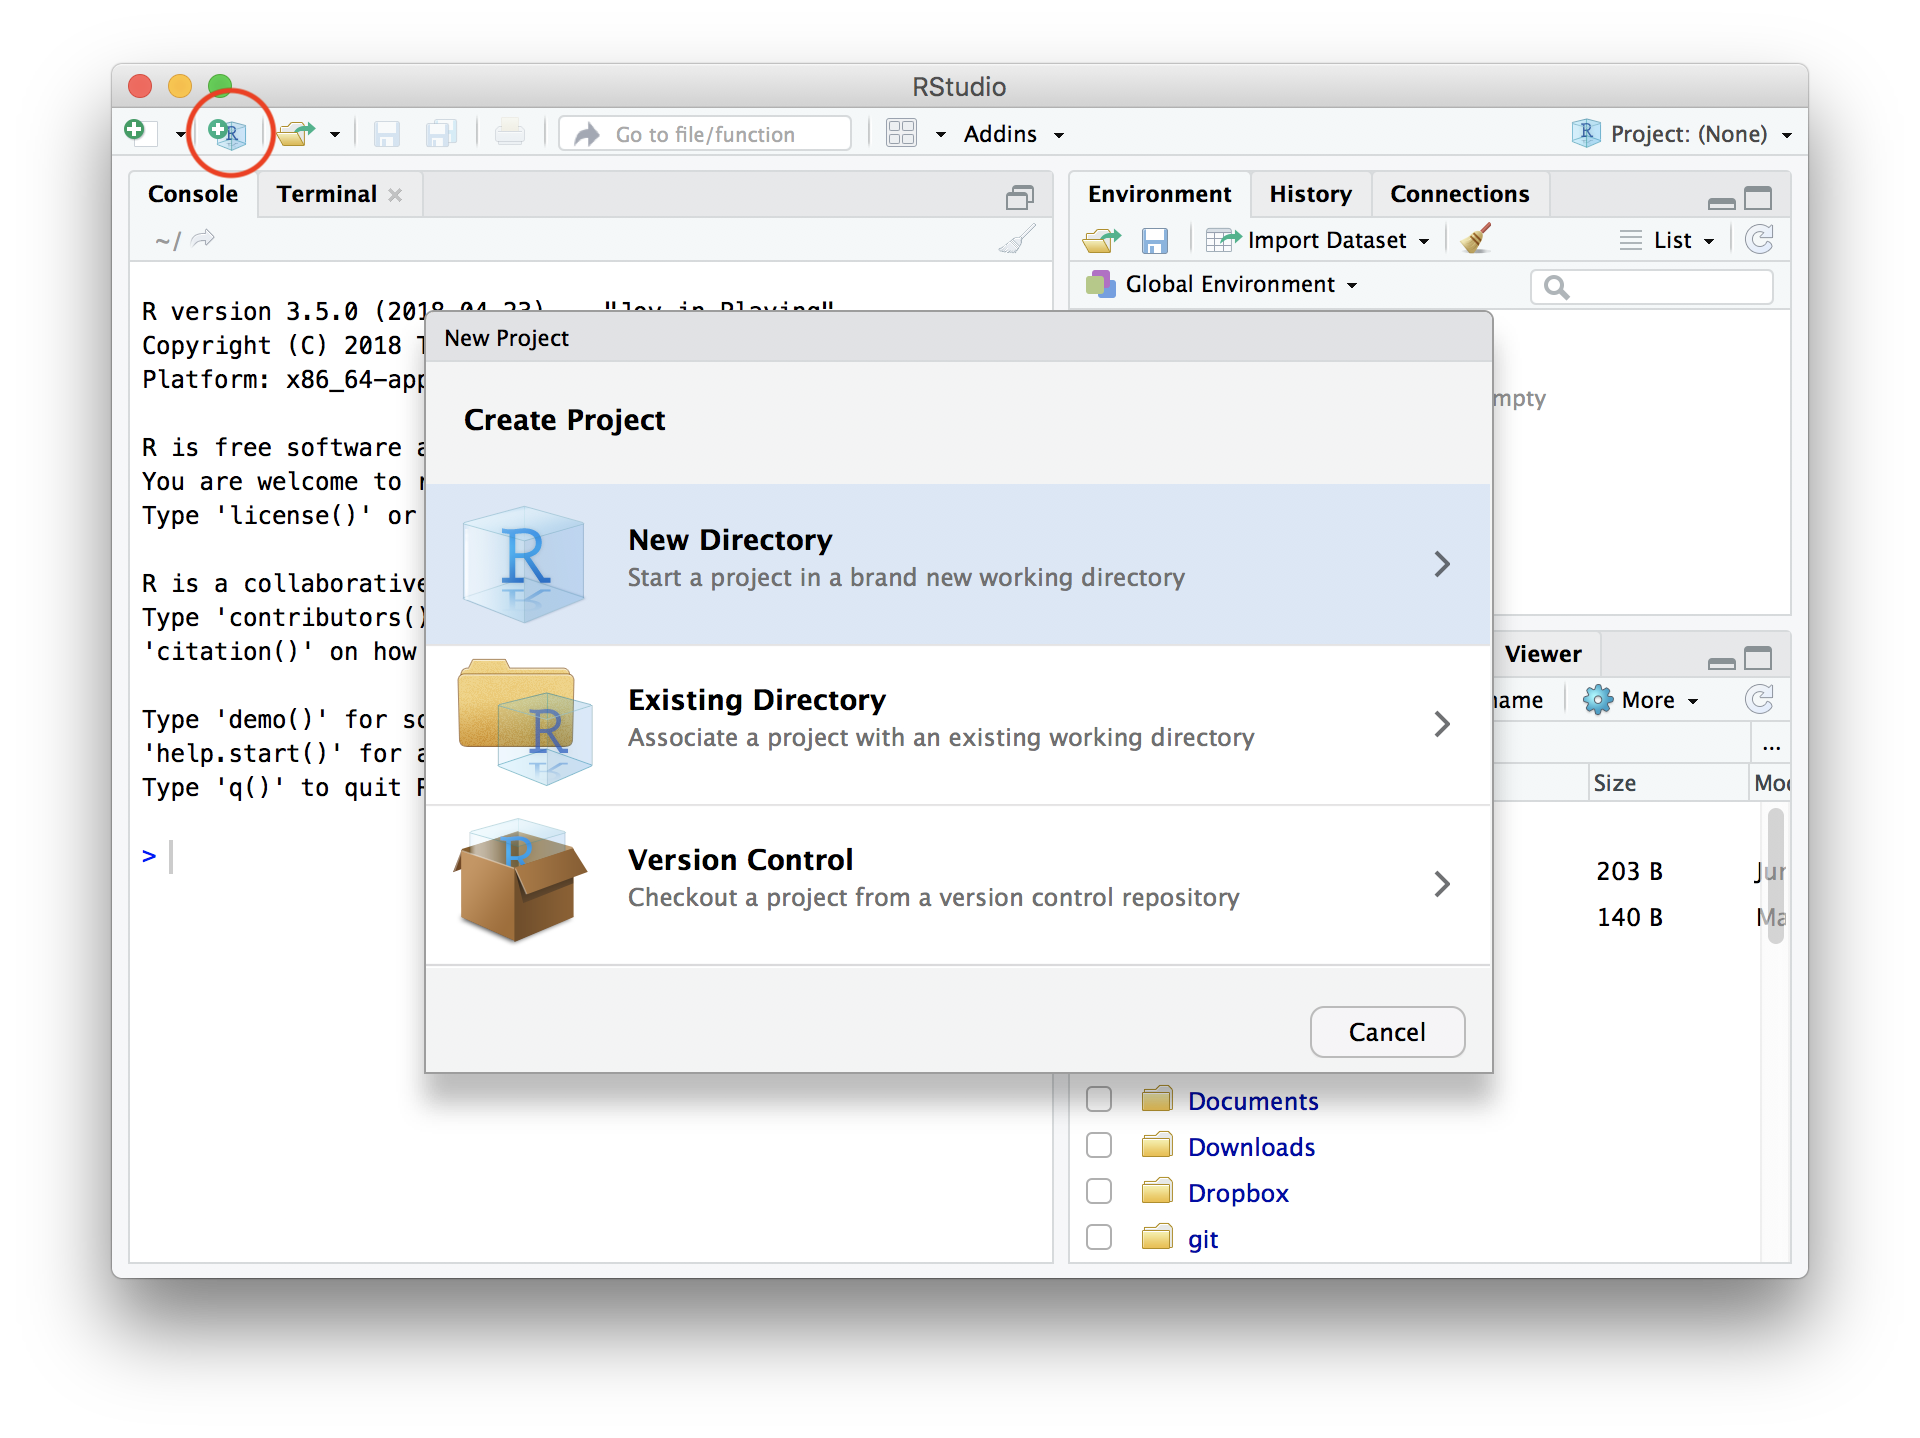
“Project” を新規作成する
File → New Project… → New Directory → New Project →
→ Directory name: r-training-2023
→ as subdirectory of: ~/project or C:/Users/yourname/project
📁 ディレクトリ = フォルダ。 ~/ = ホームディレクトリ
Rスクリプトに書いてから実行
File → New File → R script
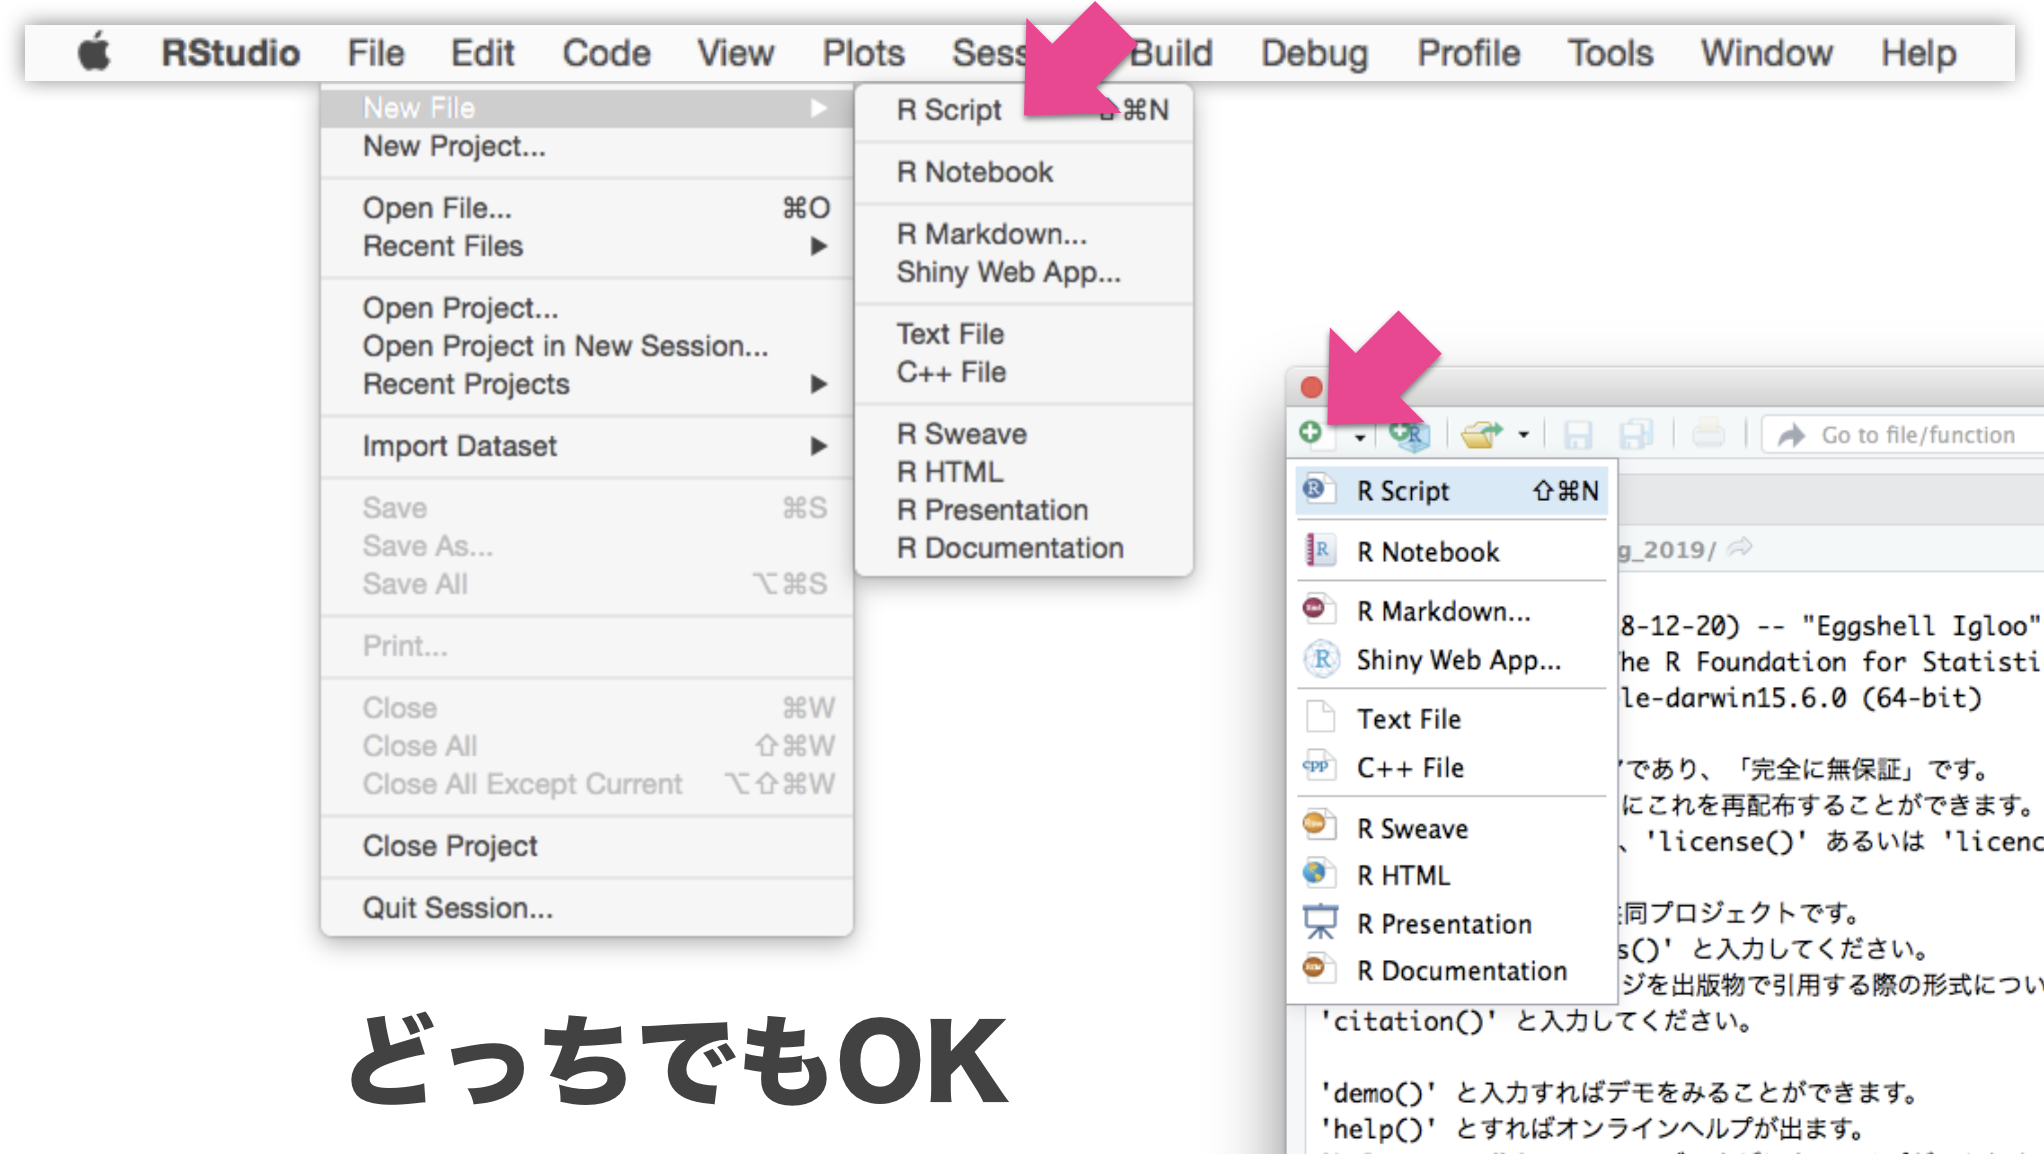
Rスクリプトに書いてから実行
File → New File → R script
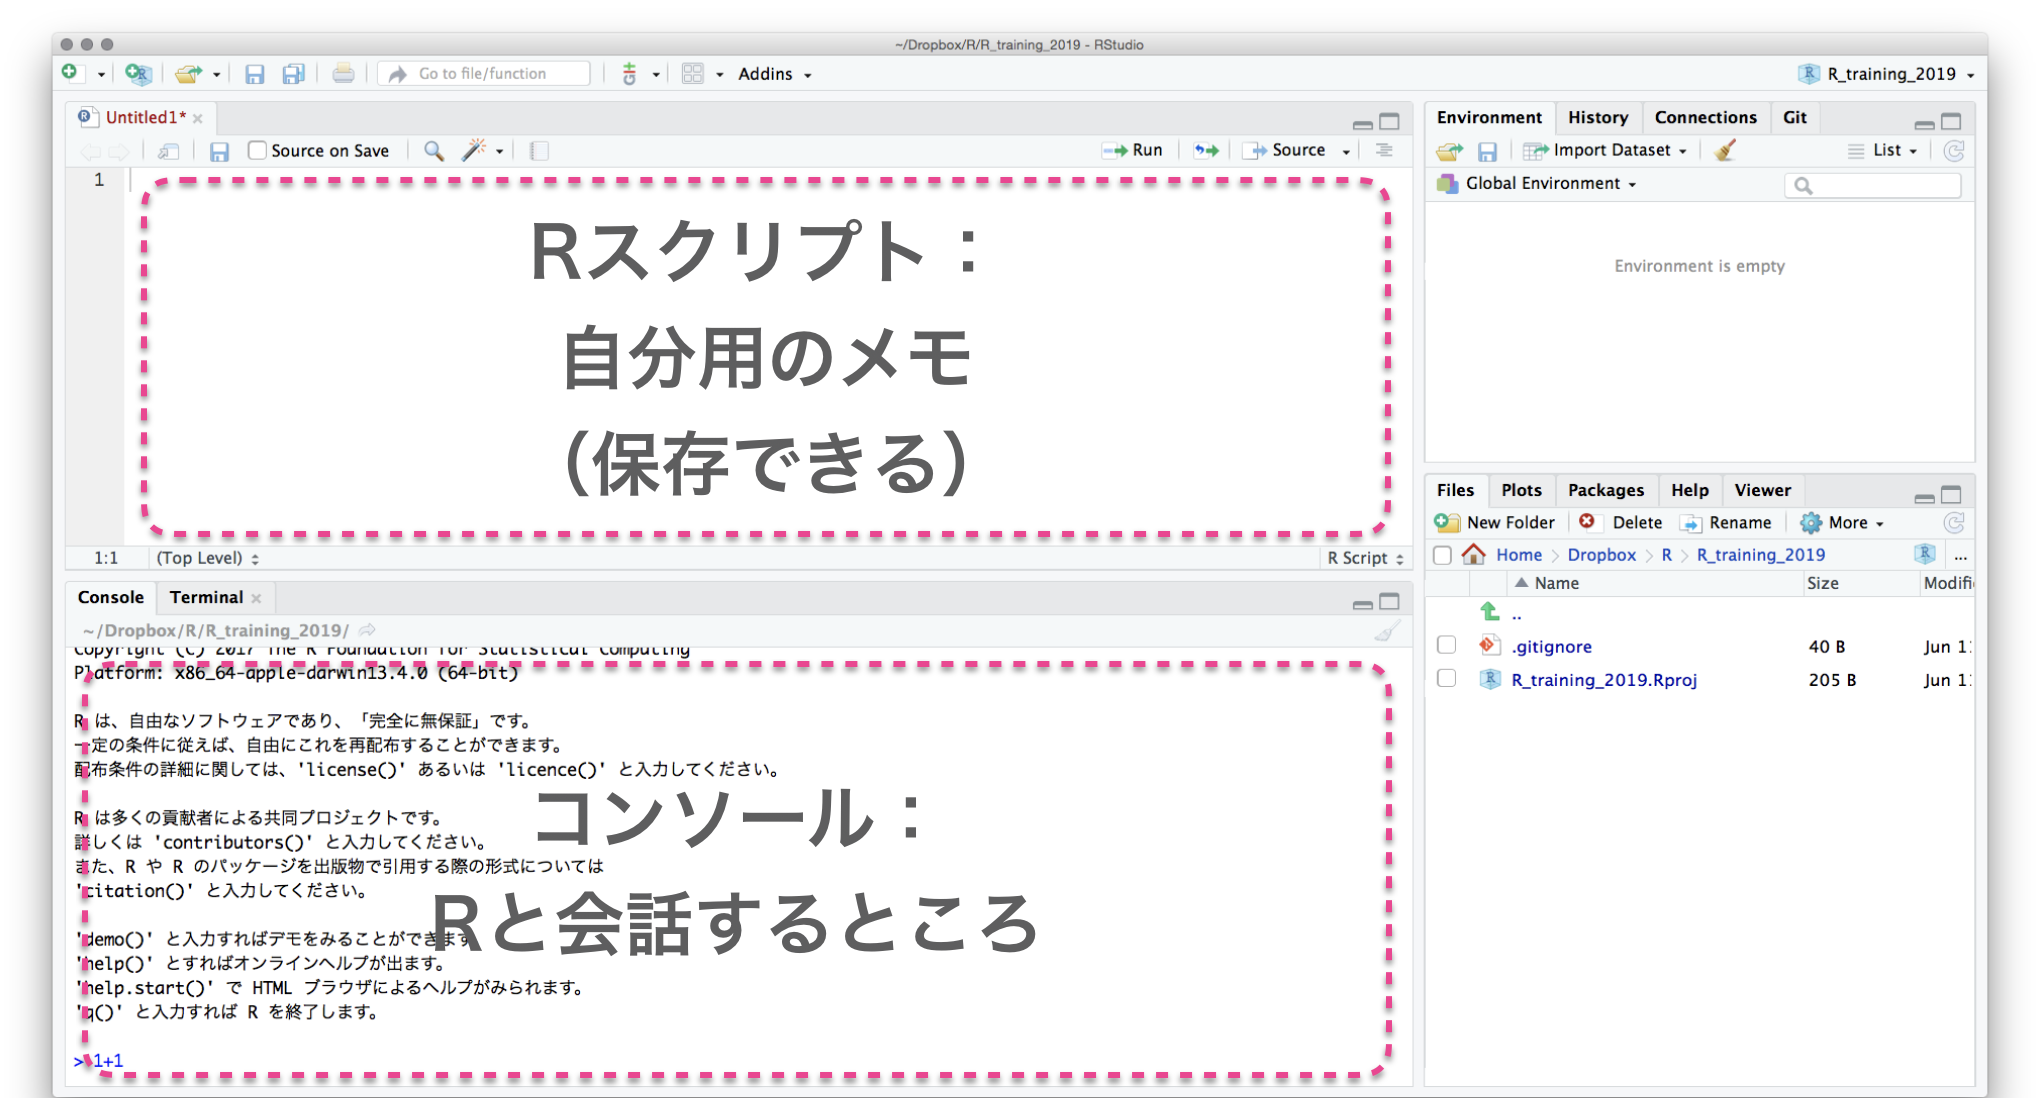
Rスクリプトに書いてから実行
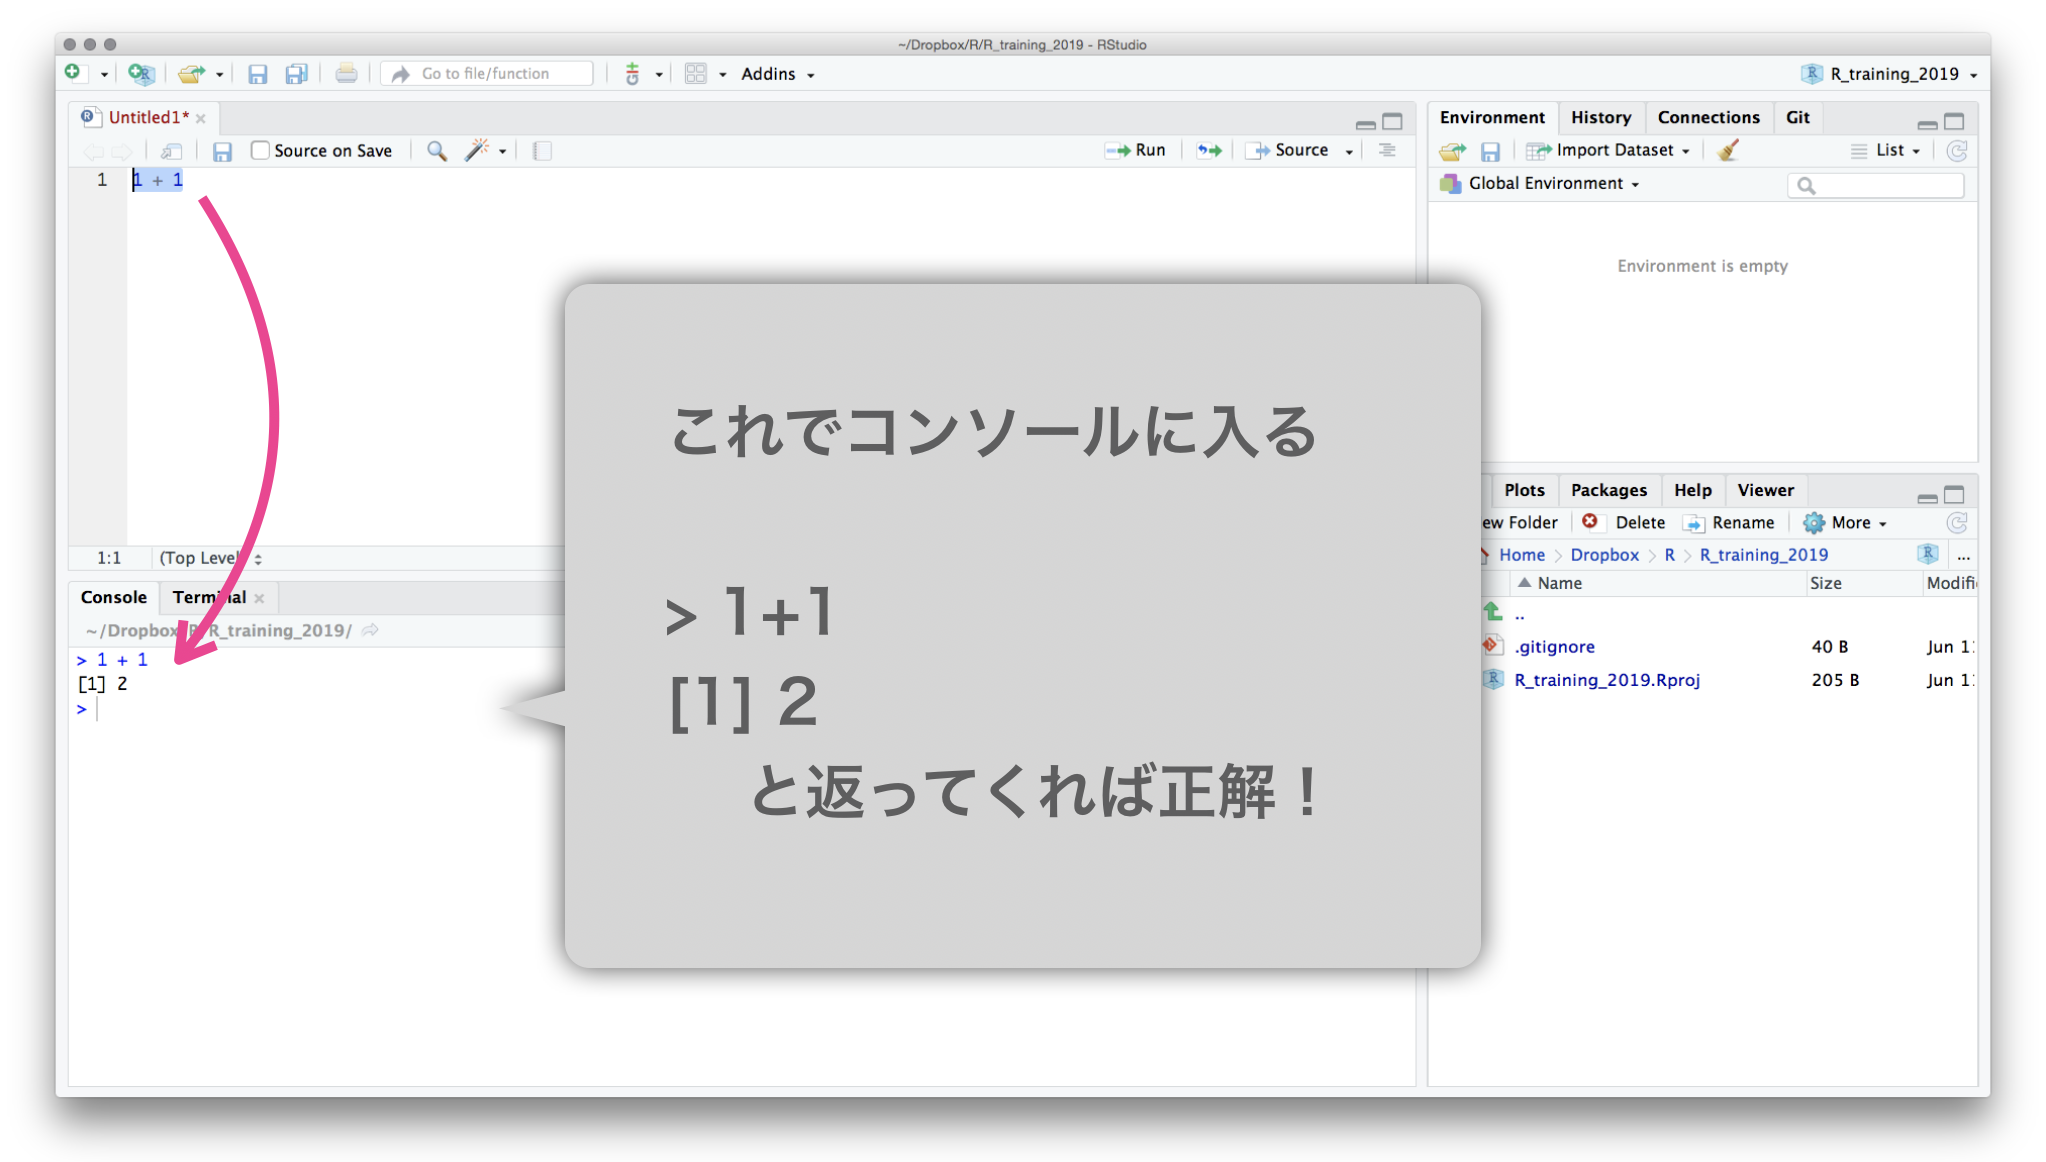
Select text with shift←↓↑→
Execute them with ctrlreturn
Rスクリプトを保存する
- 手順
- File → Save commands
- ファイル名:
hello.R - 場所: さっき作ったプロジェクト内 (デフォルトでそうなるはず)
- スクリプトを書いたら消さずに保存すること!
- 書いたスクリプトは財産
- 保存しておけばまた使い回せる
🔰 いろんな四則演算を試して hello.R に保存してみよう。
e.g., 1 + 2 + 3, 3 * 7 * 2, 4 / 2, 4 / 3, etc.
プロジェクト📁にファイルが溜まっていく
スクリプト、データ、結果を分けて整理する例:
r-training-2023/           # プロジェクトの最上階
├── r-training-2023.Rproj  # これダブルクリックでRStudioを起動
├── hello.R
├── transform.R            # データ整理・変形のスクリプト
├── visualize.R            # 作図のスクリプト
├── data/                  # 元データを置くところ
│   ├── iris.tsv
│   └── diamonds.xlsx
└── output/                # 結果の出力先
    ├── iris-petal.png
    └── iris-summary.tsv
プロジェクト最上階を作業ディレクトリとし、
ファイル読み書きの基準にする。(後で詳しく)
ほんの一例です。好きな構造に決めてください。
作業ディレクトリ: Rにとっての現在地 getwd()
- ファイル読み書き、画像の保存などはここが基準。
*.RprojダブルクリックでRStudioを開けば、いい位置で作業再開。
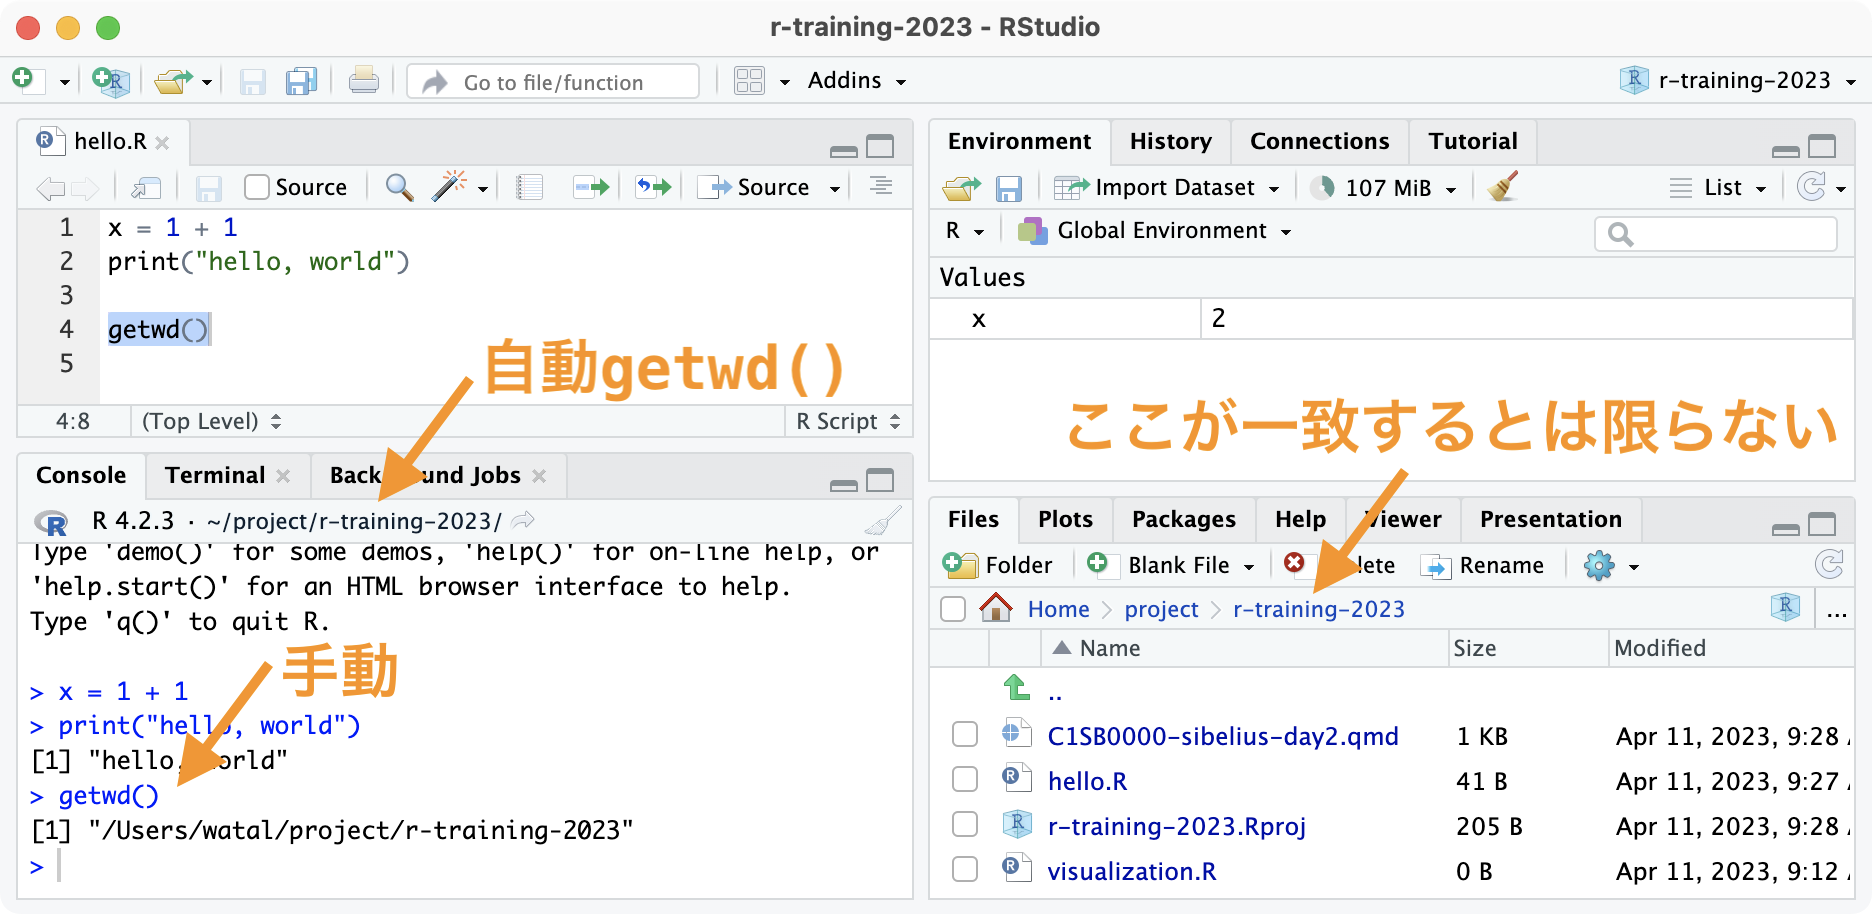
setwd("目的地") で移動できるけど、しない方針。
Rと接する上での心構え
- エラー文を恐れない
- 熟練プログラマでも頻繁にエラーを起こす。
- エラーはRからのメッセージ。意図を読み取って修正しよう。
- プログラミングの経験値 ≈ エラー解決の経験値
- 困ったらウェブ検索
- あなたの問題は全世界のRユーザーが既に通った道。
- 日本語で、英語で、エラー文そのもので検索すれば解決策に当たる。
この実習の取り組み方
とにかく手を動かして体感しよう!
- こういう枠が出てきたら、自分のRスクリプトにコピペして保存:
head(iris) - 実行してコンソールを確認。思ったとおりの出力?
ErrorやWarningがあったらよく読んで対処する。
(無視していいWarningもたまーにあるけど) - 🔰若葉マークの練習問題があれば解いてみる。
そこまでのコードのコピペ+改変でできるはず。
疑問・困りごとがある場合は気軽にChat欄に書き込んでください。
変数/オブジェクトを作ってみよう
x = 2        # Create x
x            # What's in x?
[1] 2
y = 5        # Create y
y            # What's in y?
[1] 5
Rでは代入演算子として矢印 <- も使えるけど私は = 推奨。
# 記号より右はRに無視される。コメントを書くのに便利。
x + y
[1] 7
🔰 x と y の引き算、掛け算、割り算をやってみよう
基本的な演算
+ とか * のような演算子(operator)を変数の間に置く。
10 + 3    # addition
10 - 3    # subtraction
10 * 3    # multiplication
10 / 3    # division
10 %/% 3  # integer division
10 %% 3   # modulus 剰余
10 ** 3   # exponent 10^3
🔰 コピペして結果を確認してみよう。
関数 (function)
変数を受け取って、何か仕事して、返す命令セット
x = seq(1, 3)  # 1と3を渡すとvectorが返ってくる
x
[1] 1 2 3
sum(x) # vectorを渡すと足し算が返ってくる
[1] 6
square = function(something) {  # 自分の関数を定義
  something ** 2
}
square(x)                       # 使ってみる
[1] 1 4 9
🔰 自分の関数を何か作ってみよう。
e.g., 2倍にする関数 twice
変数/オブジェクトを作ってみよう Part 2
x = 42       # Create x
x            # What's in x?
[1] 42
y = "24601"  # Create y
y            # What's in y?
[1] "24601"
この x と y を足そうとするとエラーになる。なぜ?
x + y # Error! Why?
Error in x + y: non-numeric argument to binary operator
変数/オブジェクトの型
class(x)
[1] "numeric"
is.numeric(x)
[1] TRUE
is.character(x)
[1] FALSE
as.character(x)
[1] "42"
🔰 さっき作った y にも同じ関数を適用してみよう。
変数/オブジェクトの型
vector: 基本型。一次元の配列。logical: 論理値 (TRUEorFALSE)numeric: 数値 (整数42Lor 実数3.1416)character: 文字列 ("a string")factor: 因子 (文字列っぽいけど微妙に違う)
array: 多次元配列。vector同様、全要素が同じ型。matrix: 行列 = 二次元の配列。
list: 異なる型でも詰め込める太っ腹ベクトル。data.frame: 同じ長さのベクトルを並べた長方形のテーブル。重要。
tibbleとかtbl_dfと呼ばれる亜種もあるけどほぼ同じ。
vector: 一次元の配列
1個の値でもベクトル扱い。
同じ長さ(または長さ1)の相手との計算が得意。
x = c(1, 2, 9)  # 長さ3の数値ベクトル
x + x           # 同じ長さ同士の計算
[1] 2 4 18
y = 10          # 長さ1の数値ベクトル
x + y           # 長さ3 + 長さ1 = 長さ3 (それぞれ足し算)
[1] 11 12 19
x < 5 # 5より小さいか
[1] TRUE TRUE FALSE
🔰 この x, y を使っていろいろな演算を試してみよう
vectorから部分的に抜き出す
[] を使う。番号は1から始まる。
letters
[1] "a" "b" "c" "d" "e" "f" "g" "h" "i" "j" "k" "l" "m" "n" "o" "p" "q" "r" "s" "t" "u" "v" "w" "x" "y" "z"
letters[3]
[1] "c"
letters[seq(4, 6)] # 4 5 6
[1] "d" "e" "f"
letters[seq(1, 26) < 4] # TRUE TRUE TRUE FALSE FALSE ...
[1] "a" "b" "c"
vectorを渡した結果は関数によって異なる
各要素に適用するもの:
x = c(1, 2, 9)
y = sqrt(x)     # square root
y
[1] 1.000000 1.414214 3.000000
全要素を集約した値を返すもの:
z = sum(x)
z
[1] 12
🔰 log(), exp(), length(), max(), mean()
にvectorを渡してみよう。
matrix: 二次元の配列 (行列)
1本のvectorを折り曲げて長方形にしたもの。
中身は全て同じ型。機械学習とか画像処理とかで使う。
v = seq(1, 8)              # c(1, 2, 3, 4, 5, 6, 7, 8)
x = matrix(v, nrow = 2)    # 2行に畳む。列ごとに詰める
x
     [,1] [,2] [,3] [,4]
[1,]    1    3    5    7
[2,]    2    4    6    8
y = matrix(v, nrow = 2, byrow = TRUE)  # 行ごとに詰める
y
     [,1] [,2] [,3] [,4]
[1,]    1    2    3    4
[2,]    5    6    7    8
🔰 結果を確認してみよう: x + y, dim(x), nrow(x), ncol(x).
行 (row), 列 (column) の憶え方

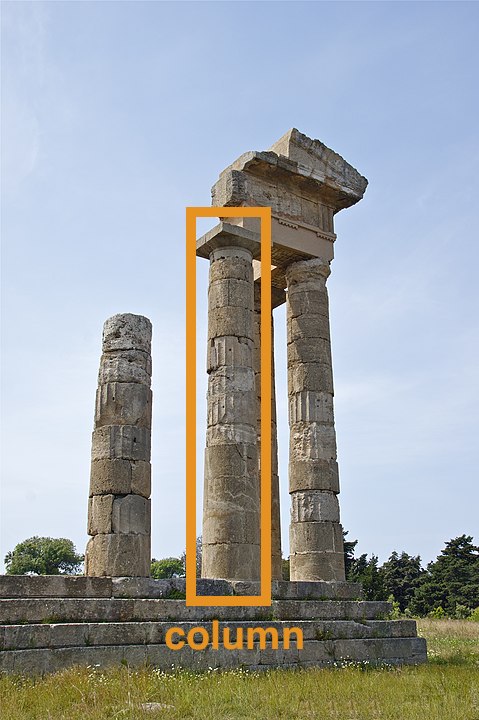
data.frame: 長方形のテーブル (重要!)
同じ長さの列vectorを複数束ねた長方形の表。
e.g., 長さ150の数値ベクトル4本と因子ベクトル1本:
print(iris)
    Sepal.Length Sepal.Width Petal.Length Petal.Width   Species
  1          5.1         3.5          1.4         0.2    setosa
  2          4.9         3.0          1.4         0.2    setosa
  3          4.7         3.2          1.3         0.2    setosa
  4          4.6         3.1          1.5         0.2    setosa
 --
147          6.3         2.5          5.0         1.9 virginica
148          6.5         3.0          5.2         2.0 virginica
149          6.2         3.4          5.4         2.3 virginica
150          5.9         3.0          5.1         1.8 virginica
iris はアヤメ属3種150個体に関する測定データ。
Rに最初から入ってて、例としてよく使われる。
data.frameを眺める
概要を掴む:
head(iris, 6)   # 先頭だけ見てみる。末尾は tail()
nrow(iris)      # 行数: Number of ROWs
ncol(iris)      # 列数: Number of COLumns
names(iris)     # 列名
summary(iris)   # 要約
View(iris)      # RStudioで閲覧
str(iris) # 構造が分かる形で表示
tibble [150 × 5] (S3: tbl_df/tbl/data.frame)
 $ Sepal.Length: num [1:150] 5.1 4.9 4.7 4.6 5 5.4 4.6 5 4.4 4.9 ...
 $ Sepal.Width : num [1:150] 3.5 3 3.2 3.1 3.6 3.9 3.4 3.4 2.9 3.1 ...
 $ Petal.Length: num [1:150] 1.4 1.4 1.3 1.5 1.4 1.7 1.4 1.5 1.4 1.5 ...
 $ Petal.Width : num [1:150] 0.2 0.2 0.2 0.2 0.2 0.4 0.3 0.2 0.2 0.1 ...
 $ Species     : Factor w/ 3 levels "setosa","versicolor",..: 1 1 1 1 1 1 1 1 1 1 ...
🔰 ほかのデータもいろいろ見てみよう。
e.g., mtcars, quakes, data()
data.frameを眺める
部分的なdata.frameを取得する:
iris[2, ]                  # 2行目
iris[2:5, ]                # 2行目から5行目まで
iris[, 3:4]                # 3-4列目
iris[2:5, 3:4]             # 2-5行目, 3-4列目
1列をvectorとして取得する:
iris[[3]]                  # 3列目
iris$Petal.Length          # Petal.Length列
iris[["Petal.Length"]]     # Petal.Length列
iris[["Petal.Length"]][2]  # Petal.Length列の2番目
結果がdata.frameになるかvectorになるか曖昧で危険、非推奨:
iris[, 3]                  # 3列目
iris[, "Petal.Length"]     # Petal.Length列
iris[2, "Petal.Length"]    # 2行目Petal.Length列
data.frameの新規作成
同じ長さの 列(column) vector を結合して作る:
x = c(1, 2, 3)
y = c("A", "B", "C")
mydata = data.frame(x, y)
print(mydata)
  x y
1 1 A
2 2 B
3 3 C
🔰 次のようなdata.frameを作って theDF と名付けよう:
 i s
24 x
25 y
26 z
ヒント: c() 無しでクリアすることも可能。
data.frameの読み書き
-
readxlパッケージを使えば
.xlsxファイルも読める、けど -
カンマ区切り(CSV)とかタブ区切り(TSV)のテキストが無難。
-
ファイル名は作業ディレクトリからの相対パスで指定。
install.packages("readr") # R標準の read.table() とかは難しいので
library(readr)            # パッケージのやつを使うよ
write_tsv(iris, "data/iris.tsv")   # 書き出し
iris2 = read_tsv("data/iris.tsv")  # 読み込み
あれれー、エラーが出る?
Error: Cannot open file for writing:
* 'data/iris.tsv'
ファイル読み書きでありがちなエラー
- 読みたいファイル名が間違っている。
- 読みたいファイルが作業ディレクトリとは違うところにある。
- 書き込み先のディレクトリが存在しない。→ 予め作っておこう
冷静に、現在の作業ディレクトリとその中身を確認しよう:
getwd()               # GET Working Directory
list.files(".")       # List files in "." (here)
list.files("data")    # List files in "./data"
dir.create("data")    # Create directory
よくあるエラー集 (石川由希さん@名古屋大) を読んでおきましょう。
🔰 R組み込みデータや自作データを読み書きしてみよう。
R package
便利な関数やデータセットなどをひとまとめにしたもの。
- Standard Packages
- Rの標準機能。何もしなくても使用可能。
- Contributed Packages
- 有志により開発され、 CRAN や Bioconductor に公開されている。
- 要インストール。使う前に読み込むおまじないが必要。
install.packages("readr")  # 一度やればOK
library(readr)             # 読み込みはRを起動するたびに必要
update.packages()          # たまには更新しよう
- 素のRも覚えきってないのにいきなりパッケージ?
- 大丈夫。誰も覚えきってない。
- パッケージを使わないR作業 = 火もナイフも使わない料理
tidyverse: データ科学のためのパッケージ群
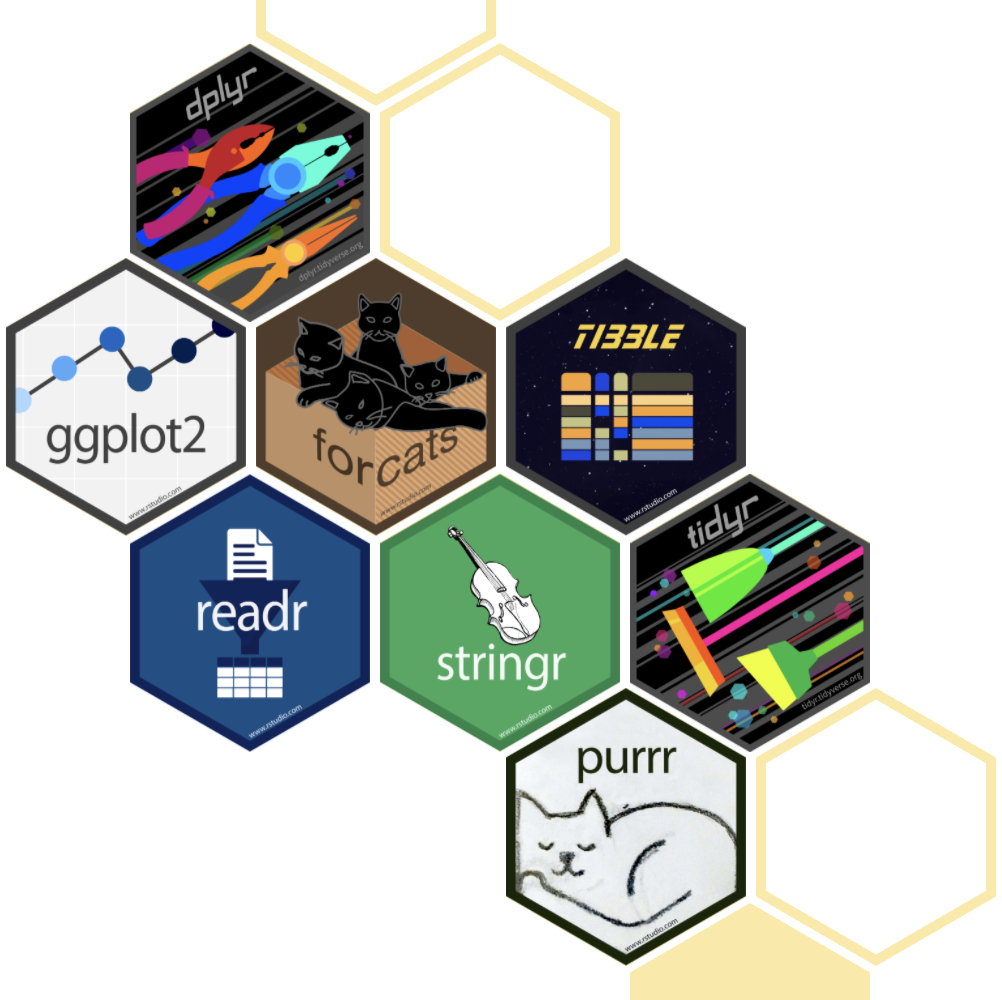
install.packages("tidyverse")
library(conflicted) # 安全のおまじない
library(tidyverse)  # 一挙に読み込み
── Attaching core tidyverse packages ──── tidyverse 2.0.0 ──
✔ dplyr     1.1.2     ✔ readr     2.1.4
✔ forcats   1.0.0     ✔ stringr   1.5.0
✔ ggplot2   3.4.2     ✔ tibble    3.2.1
✔ lubridate 1.9.2     ✔ tidyr     1.3.0
✔ purrr     1.0.1
一貫したデザインでデータ解析の様々な工程をカバー
ggplot2: tidyverseの可視化担当
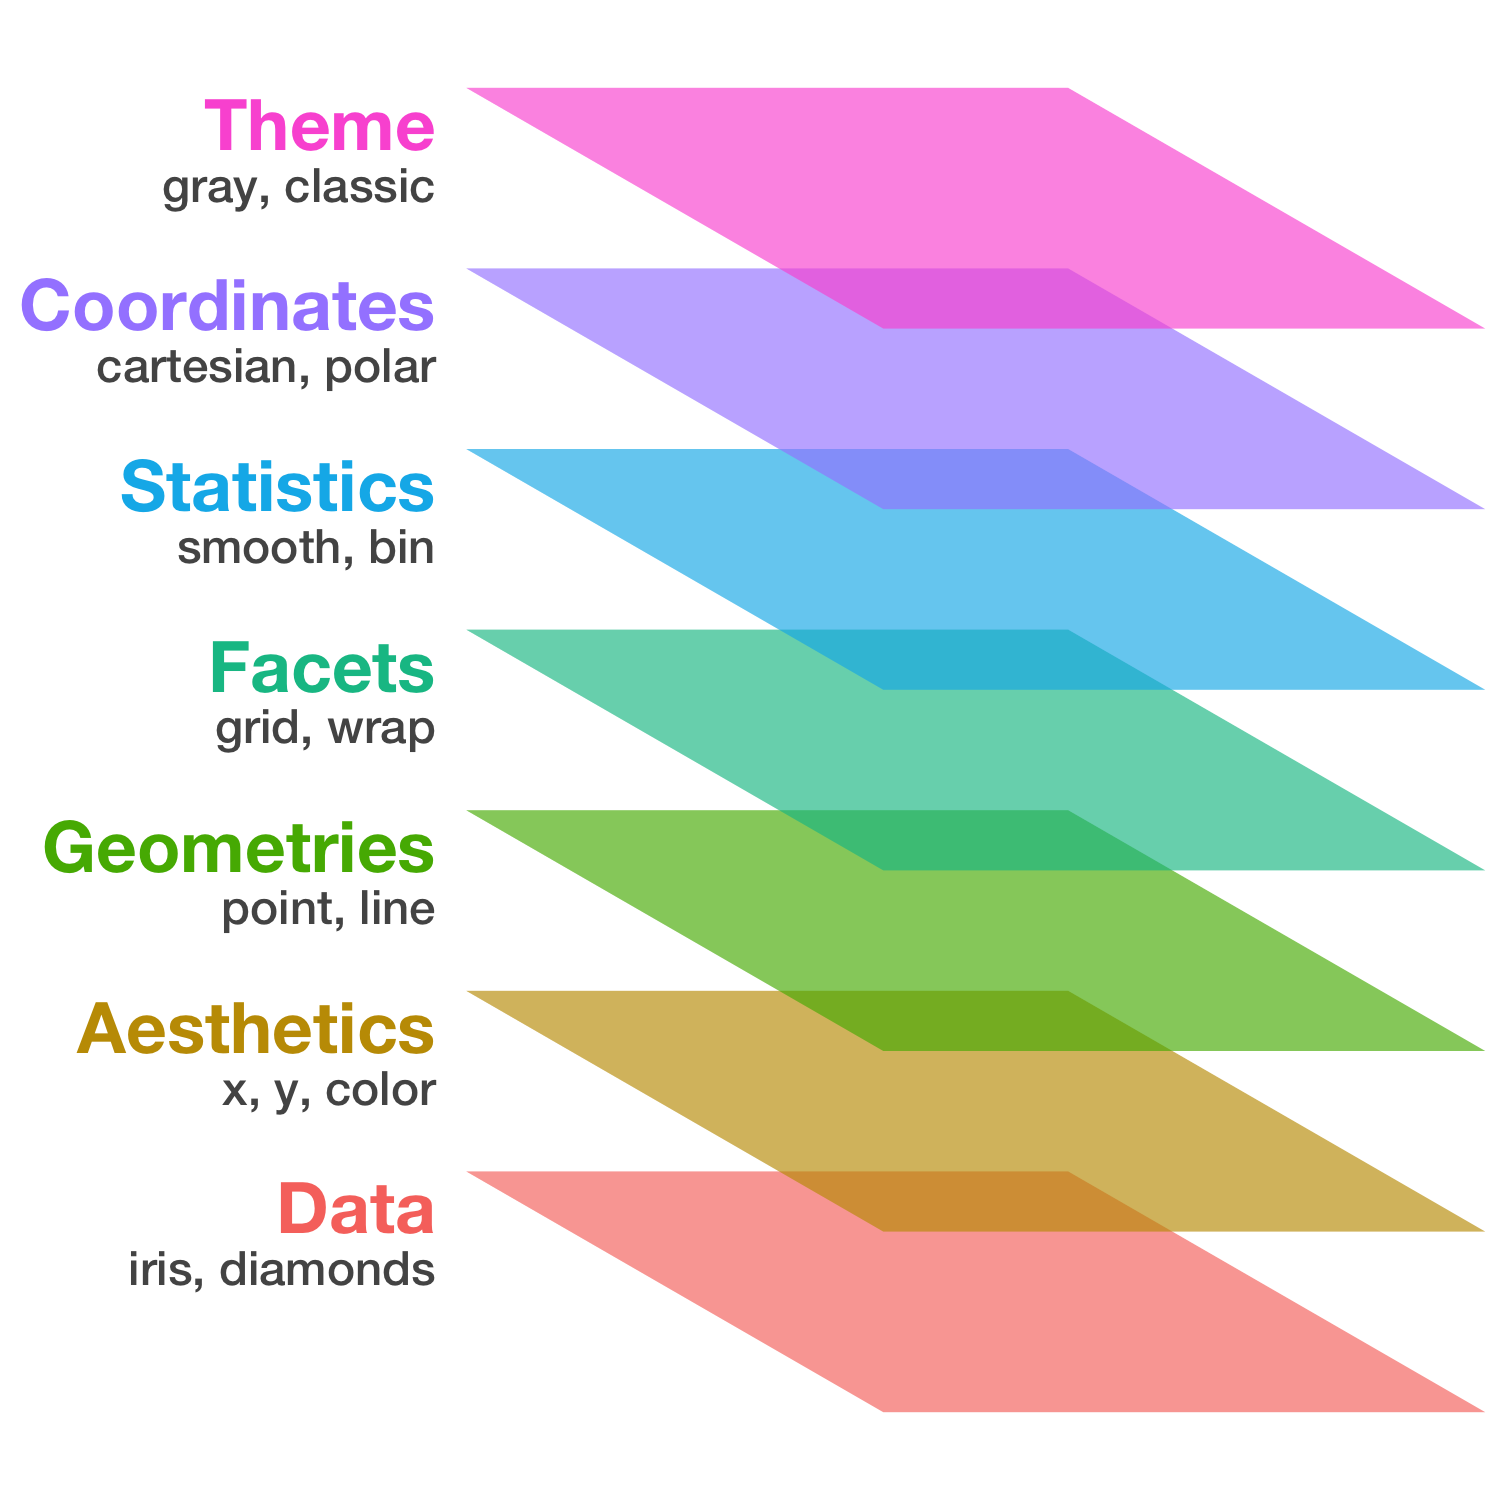
- “The Grammar of Graphics” という体系に基づく設計
- 単にいろんなグラフを「描ける」だけじゃなく
一貫性のある文法で合理的に描ける
いきなりggplot2から使い始めても大丈夫
R標準のやつとは根本的に違うシステムで作図する。

基本的な使い方: 指示を + で重ねていく
基本的な使い方: 指示を + で重ねていく
ggplot(data = diamonds)             # diamondsデータでキャンバス準備
# aes(x = carat, y = price) +       # carat,price列をx,y軸にmapping
# geom_point() +                    # 散布図を描く
# facet_wrap(vars(clarity)) +       # clarity列に応じてパネル分割
# stat_smooth(method = lm) +        # 直線回帰を追加
# coord_cartesian(ylim = c(0, 2e4)) + # y軸の表示範囲を狭く
# theme_classic(base_size = 20)     # クラシックなテーマで
基本的な使い方: 指示を + で重ねていく
ggplot(data = diamonds) +           # diamondsデータでキャンバス準備
  aes(x = carat, y = price)         # carat,price列をx,y軸にmapping
# geom_point() +                    # 散布図を描く
# facet_wrap(vars(clarity)) +       # clarity列に応じてパネル分割
# stat_smooth(method = lm) +        # 直線回帰を追加
# coord_cartesian(ylim = c(0, 2e4)) + # y軸の表示範囲を狭く
# theme_classic(base_size = 20)     # クラシックなテーマで
基本的な使い方: 指示を + で重ねていく
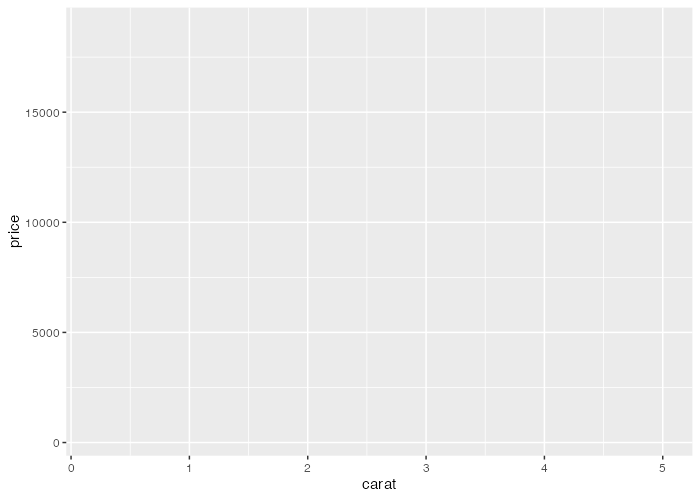
ggplot(data = diamonds) +           # diamondsデータでキャンバス準備
  aes(x = carat, y = price) +       # carat,price列をx,y軸にmapping
  geom_point()                      # 散布図を描く
# facet_wrap(vars(clarity)) +       # clarity列に応じてパネル分割
# stat_smooth(method = lm) +        # 直線回帰を追加
# coord_cartesian(ylim = c(0, 2e4)) + # y軸の表示範囲を狭く
# theme_classic(base_size = 20)     # クラシックなテーマで
基本的な使い方: 指示を + で重ねていく
ggplot(data = diamonds) +           # diamondsデータでキャンバス準備
  aes(x = carat, y = price) +       # carat,price列をx,y軸にmapping
  geom_point() +                    # 散布図を描く
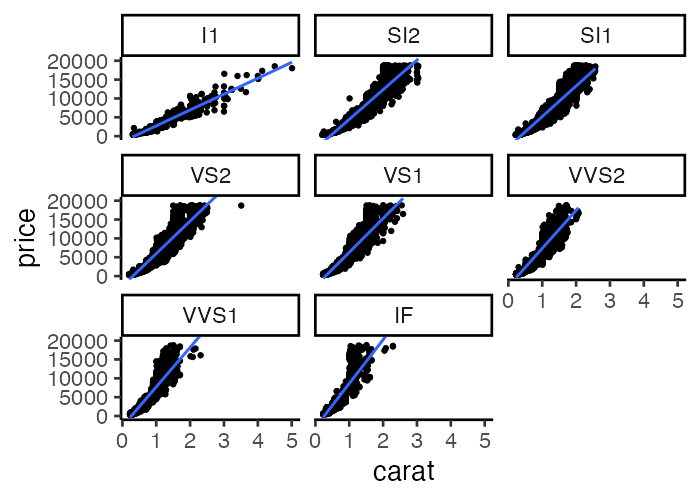
  facet_wrap(vars(clarity))         # clarity列に応じてパネル分割
# stat_smooth(method = lm) +        # 直線回帰を追加
# coord_cartesian(ylim = c(0, 2e4)) + # y軸の表示範囲を狭く
# theme_classic(base_size = 20)     # クラシックなテーマで
基本的な使い方: 指示を + で重ねていく
ggplot(data = diamonds) +           # diamondsデータでキャンバス準備
  aes(x = carat, y = price) +       # carat,price列をx,y軸にmapping
  geom_point() +                    # 散布図を描く
  facet_wrap(vars(clarity)) +       # clarity列に応じてパネル分割
  stat_smooth(method = lm)          # 直線回帰を追加
# coord_cartesian(ylim = c(0, 2e4)) + # y軸の表示範囲を狭く
# theme_classic(base_size = 20)     # クラシックなテーマで
基本的な使い方: 指示を + で重ねていく
ggplot(data = diamonds) +           # diamondsデータでキャンバス準備
  aes(x = carat, y = price) +       # carat,price列をx,y軸にmapping
  geom_point() +                    # 散布図を描く
  facet_wrap(vars(clarity)) +       # clarity列に応じてパネル分割
  stat_smooth(method = lm) +        # 直線回帰を追加
  coord_cartesian(ylim = c(0, 2e4))   # y軸の表示範囲を狭く
# theme_classic(base_size = 20)     # クラシックなテーマで
基本的な使い方: 指示を + で重ねていく
ggplot(data = diamonds) +           # diamondsデータでキャンバス準備
  aes(x = carat, y = price) +       # carat,price列をx,y軸にmapping
  geom_point() +                    # 散布図を描く
  facet_wrap(vars(clarity)) +       # clarity列に応じてパネル分割
  stat_smooth(method = lm) +        # 直線回帰を追加
  coord_cartesian(ylim = c(0, 2e4)) + # y軸の表示範囲を狭く
  theme_classic(base_size = 20)     # クラシックなテーマで
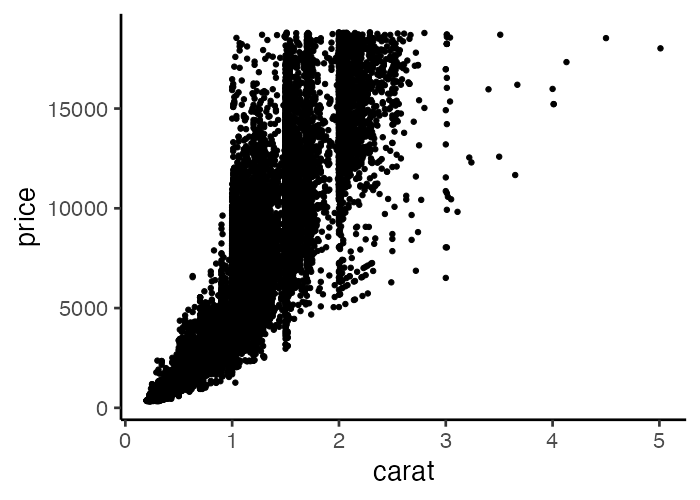
基本的な使い方: 指示を + で重ねていく
ggplot(data = diamonds) +           # diamondsデータでキャンバス準備
  aes(x = carat, y = price) +       # carat,price列をx,y軸にmapping
  geom_point() +                    # 散布図を描く
# facet_wrap(vars(clarity)) +       # clarity列に応じてパネル分割
# stat_smooth(method = lm) +        # 直線回帰を追加
# coord_cartesian(ylim = c(0, 2e4)) + # y軸の表示範囲を狭く
  theme_classic(base_size = 20)     # クラシックなテーマで
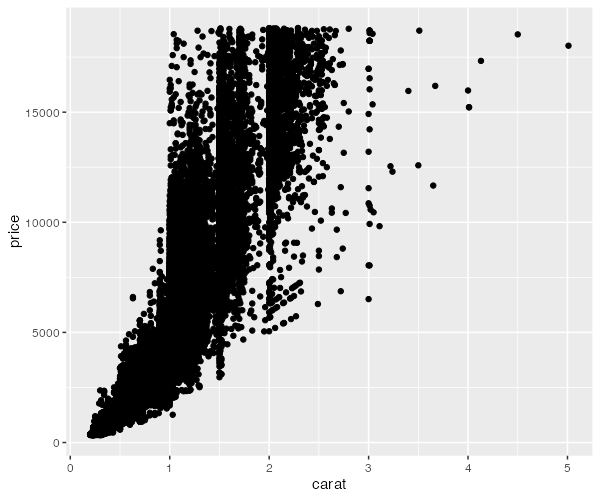
途中経過オブジェクトを取っておける
p1 = ggplot(data = diamonds)
p2 = p1 + aes(x = carat, y = price)
p3 = p2 + geom_point()
p4 = p3 + facet_wrap(vars(clarity))
print(p3)
この p3 は後で使います。
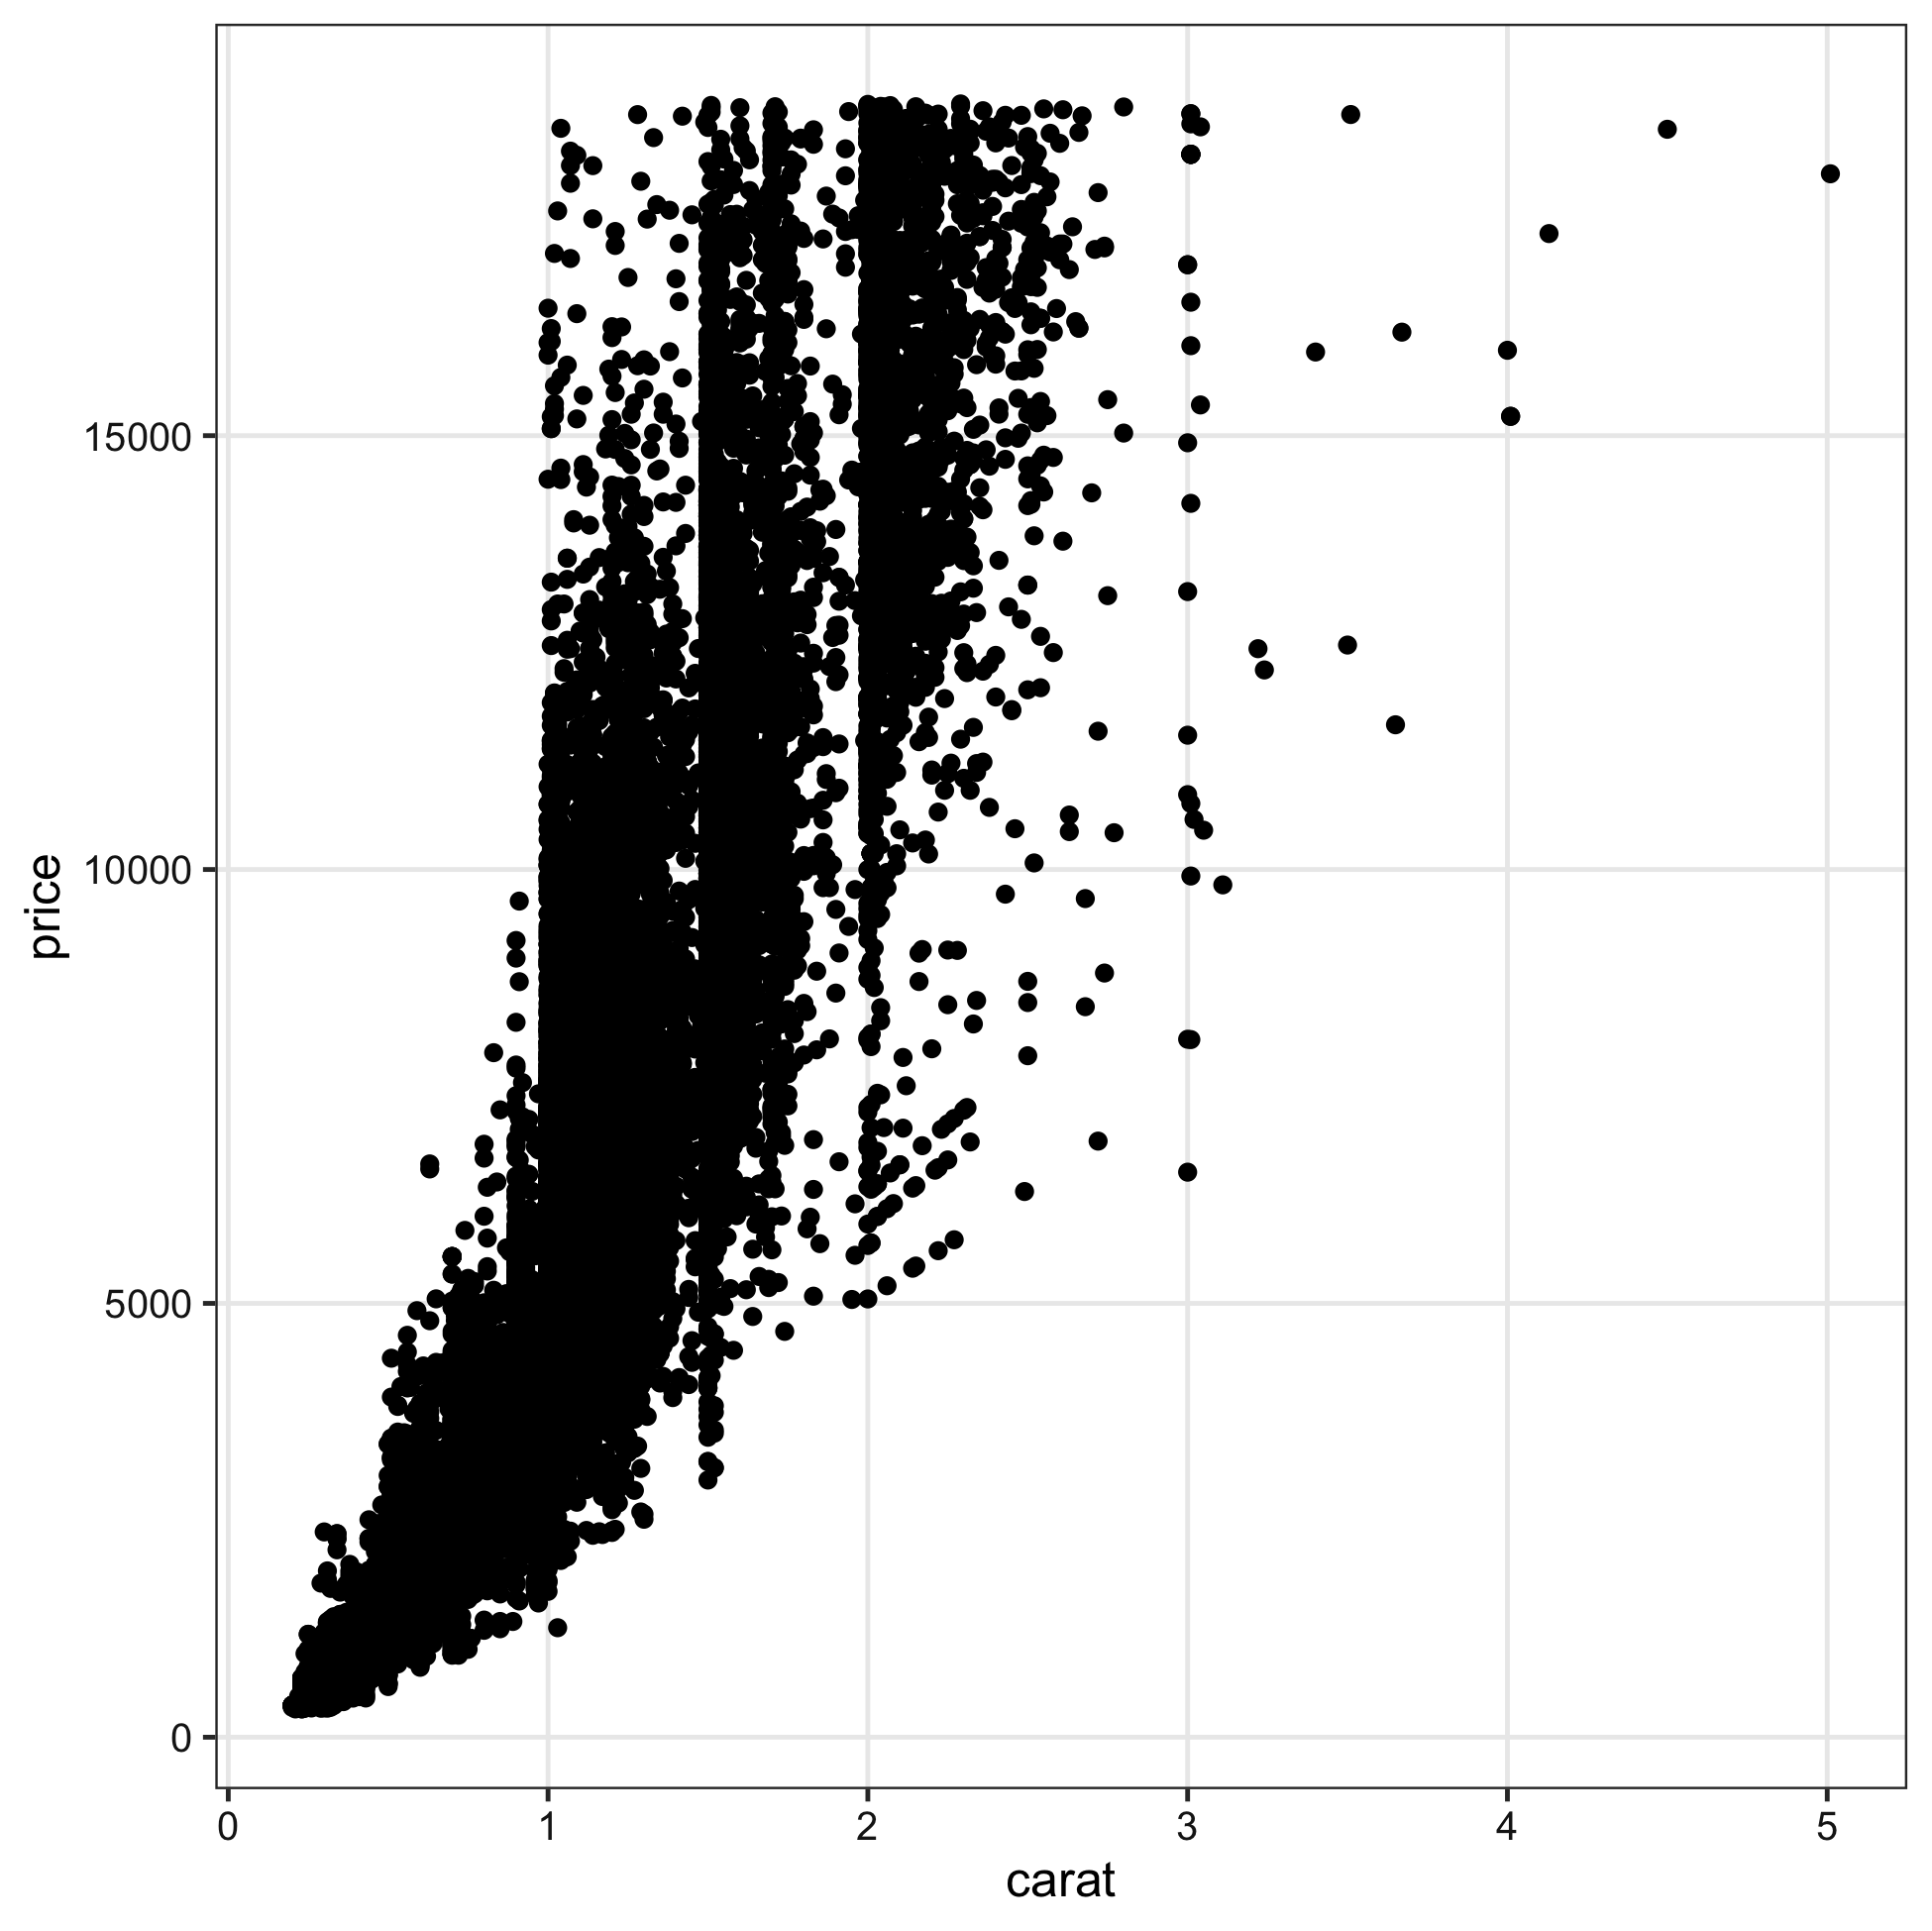
ファイル名もサイズも再現可能な作図
widthやheightが小さいほど、文字・点・線が相対的に大きく
# 7inch x 300dpi = 2100px四方 (デフォルト)
ggsave("dia1.png", p3) # width = 7, height = 7, dpi = 300
# 4     x 300    = 1200  全体7/4倍ズーム
ggsave("dia2.png", p3, width = 4, height = 4) # dpi = 300
# 2     x 600    = 1200  全体をさらに2倍ズーム
ggsave("dia3.png", p3, width = 2, height = 2, dpi = 600)
# 4     x 300    = 1200  テーマを使って文字だけ拡大
ggsave("dia4.png", p3 + theme_bw(base_size = 22), width = 4, height = 4)
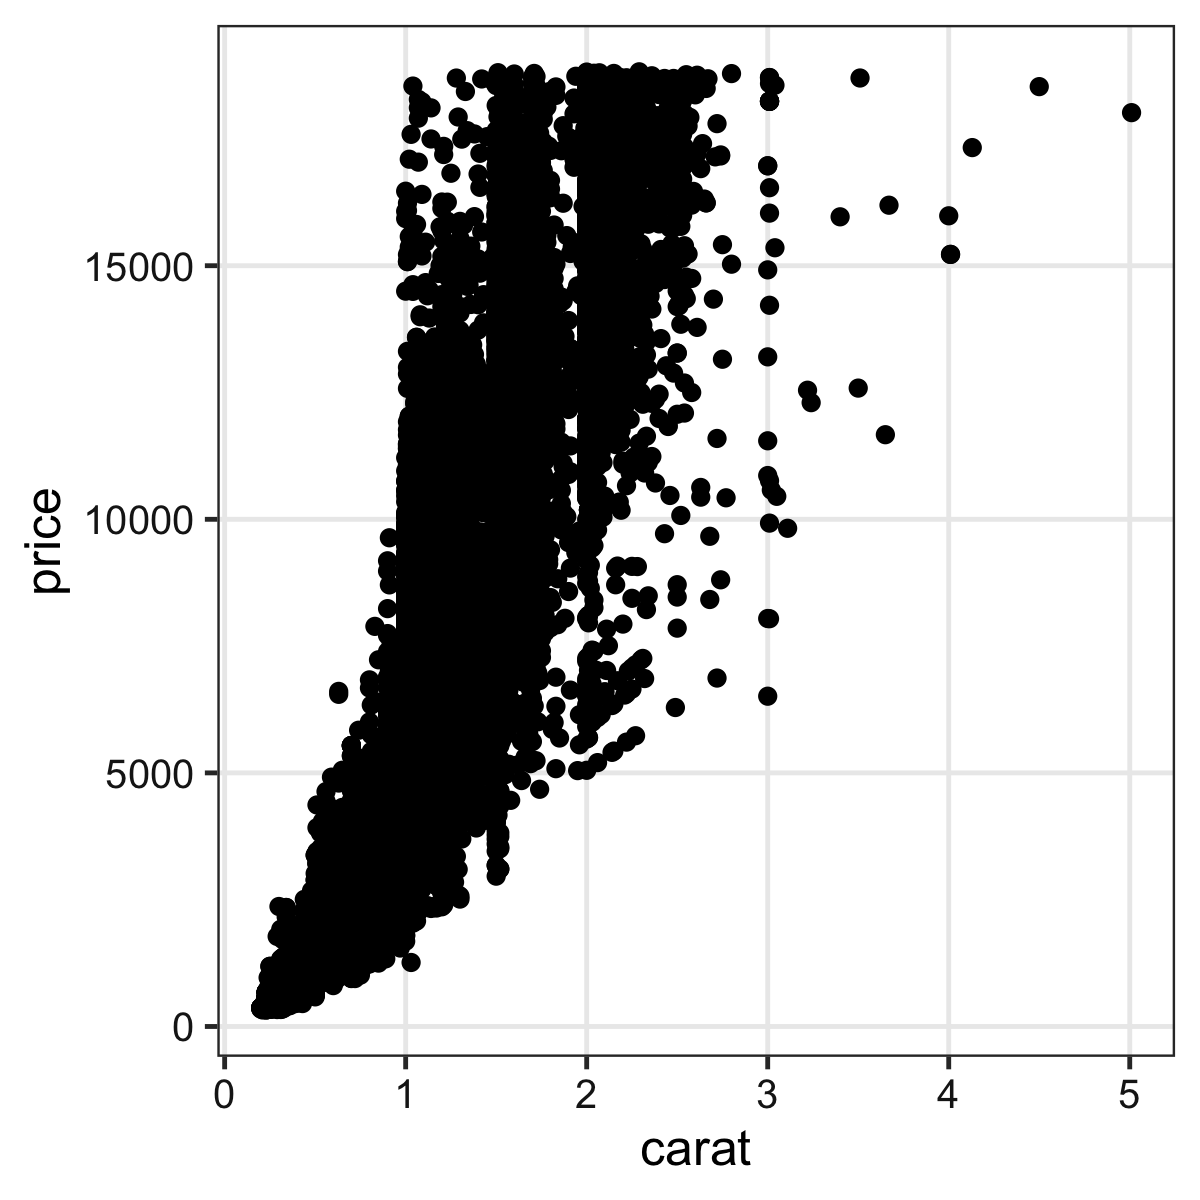
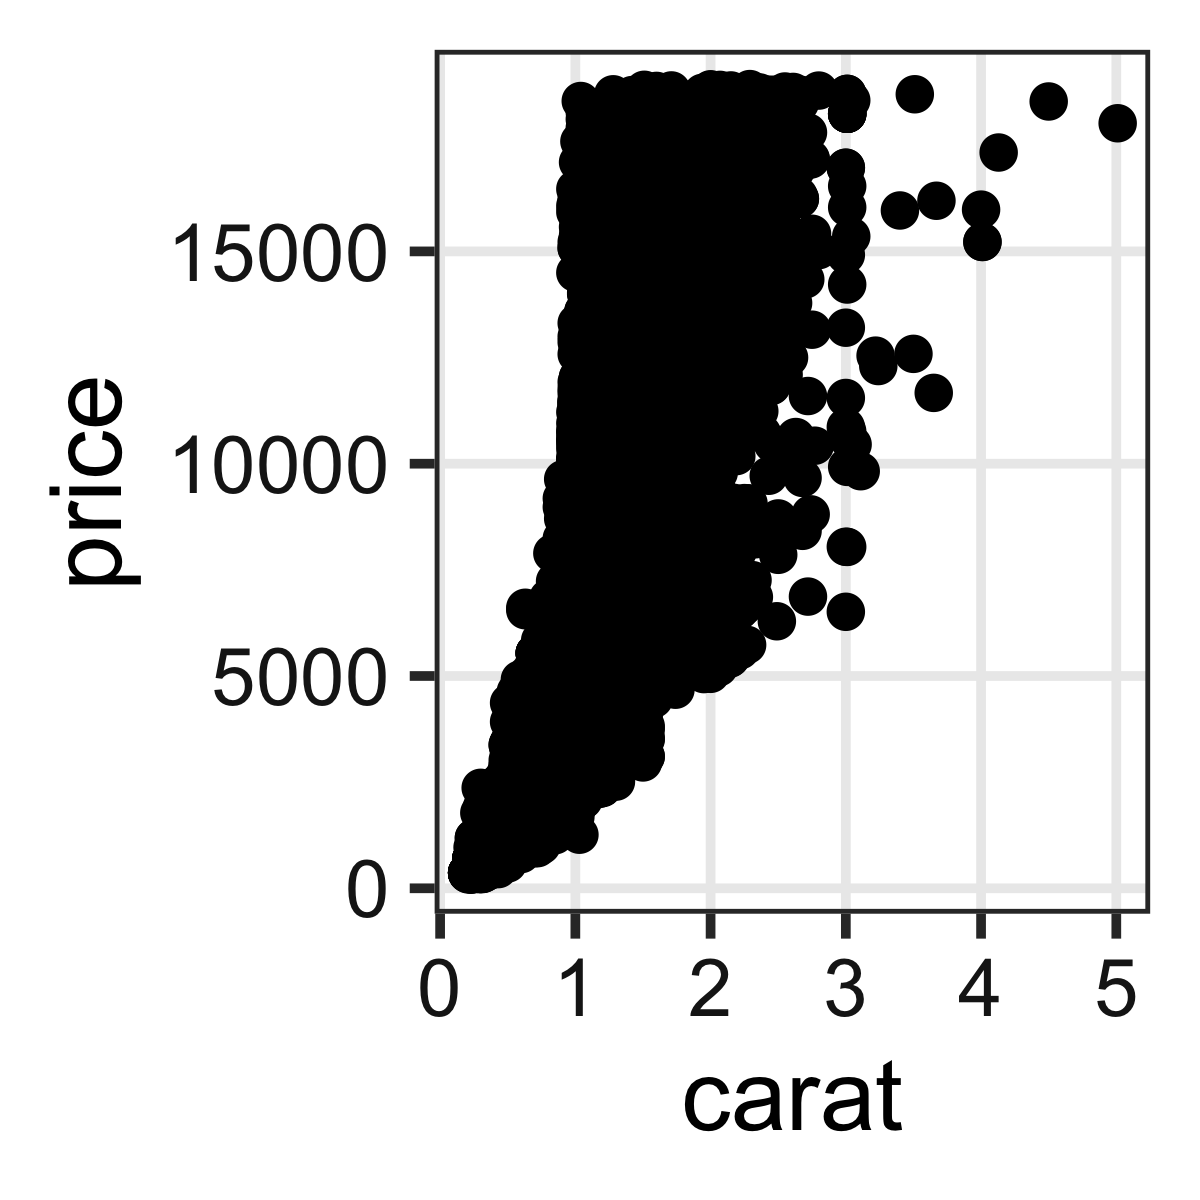
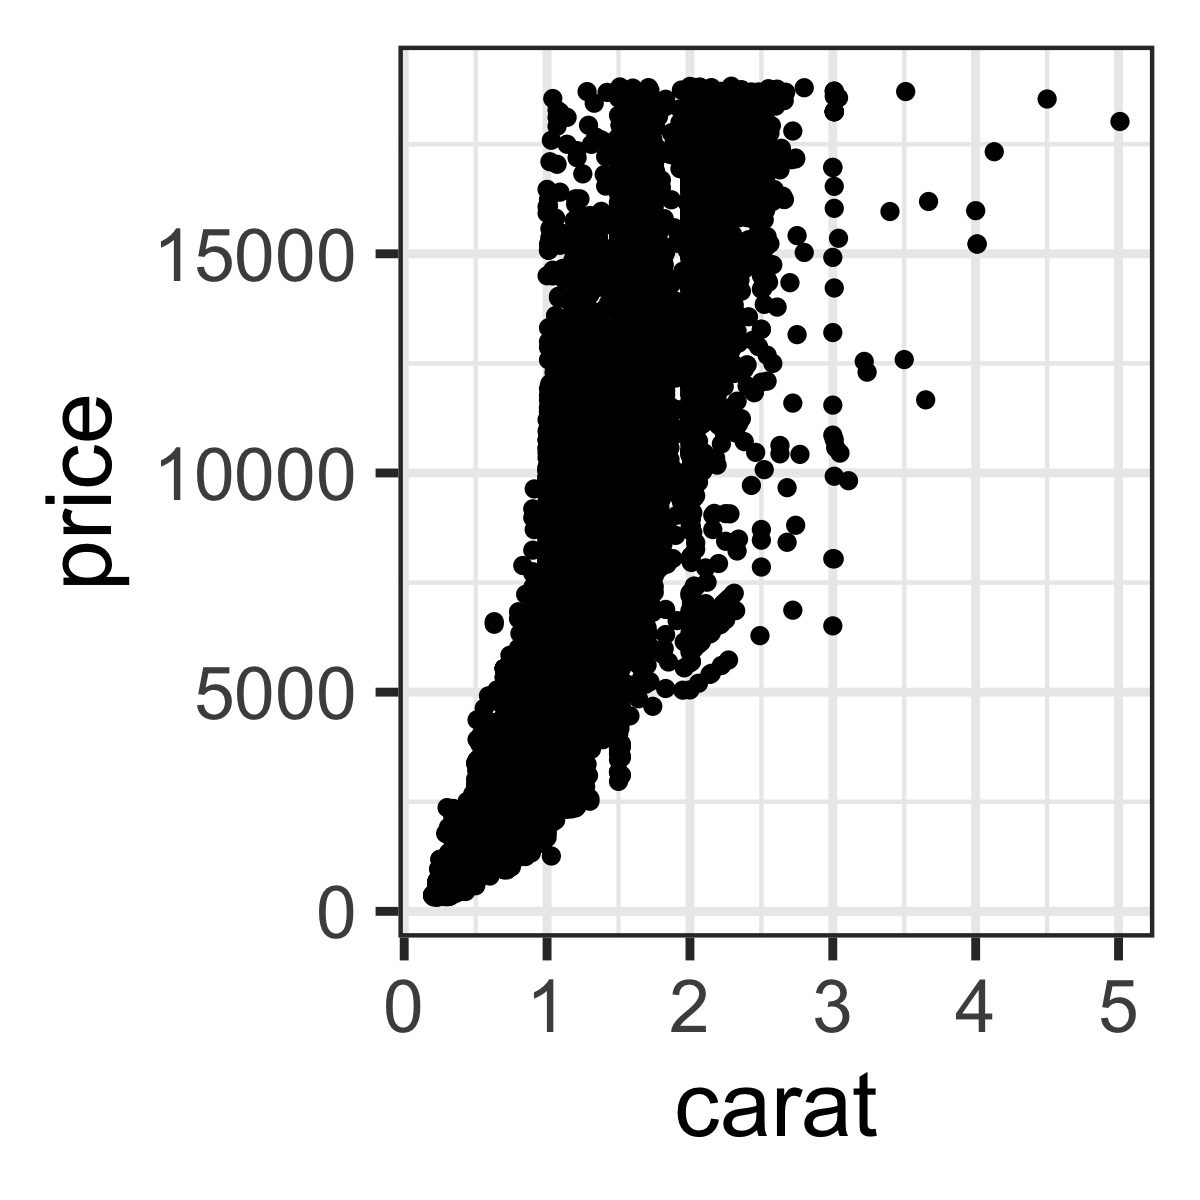
論文のFigureみたいに並べるのもRで
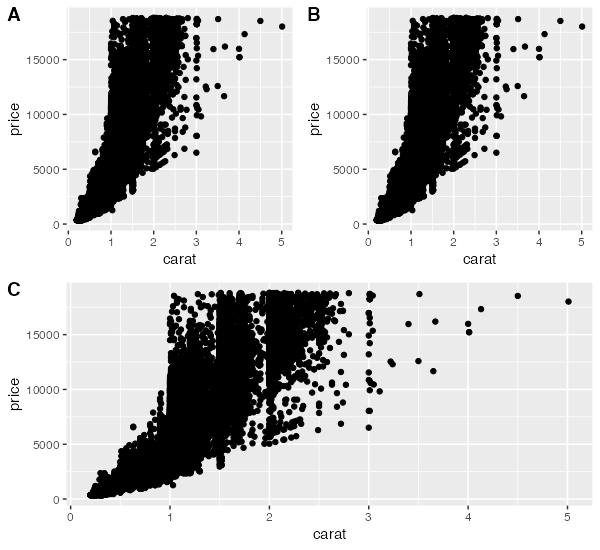
別のパッケージ (cowplot や patchwork) の助けを借りて
pAB = cowplot::plot_grid(p3, p3, labels = c("A", "B"), nrow = 1L)
cowplot::plot_grid(pAB, p3, labels = c("", "C"), ncol = 1L)
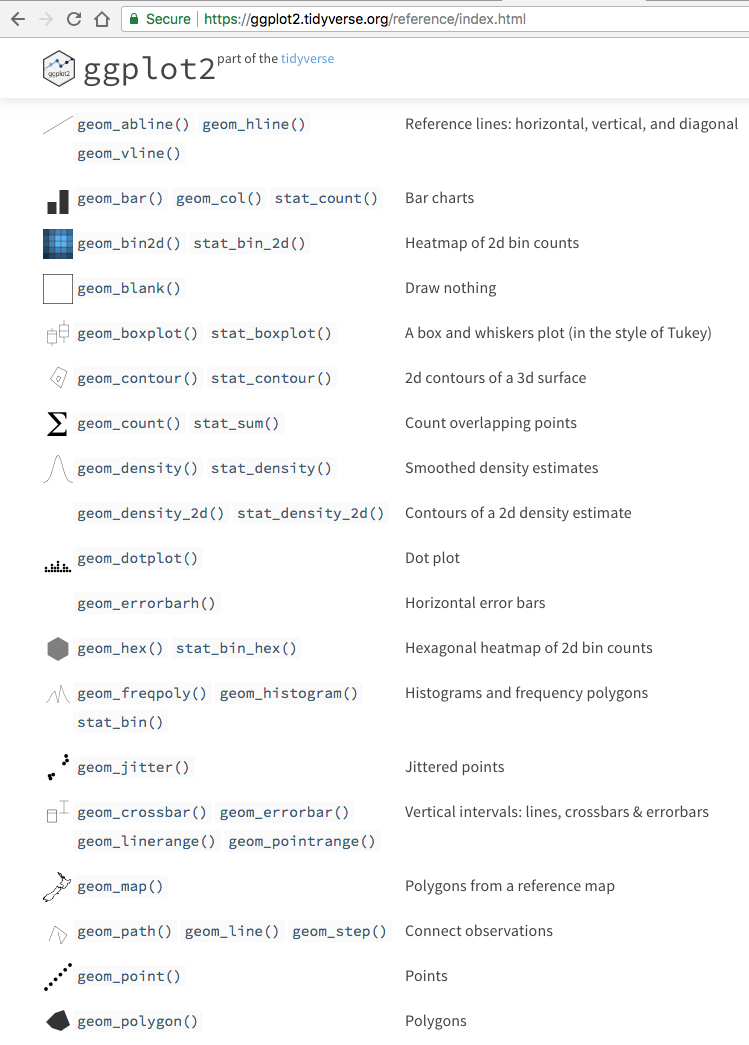
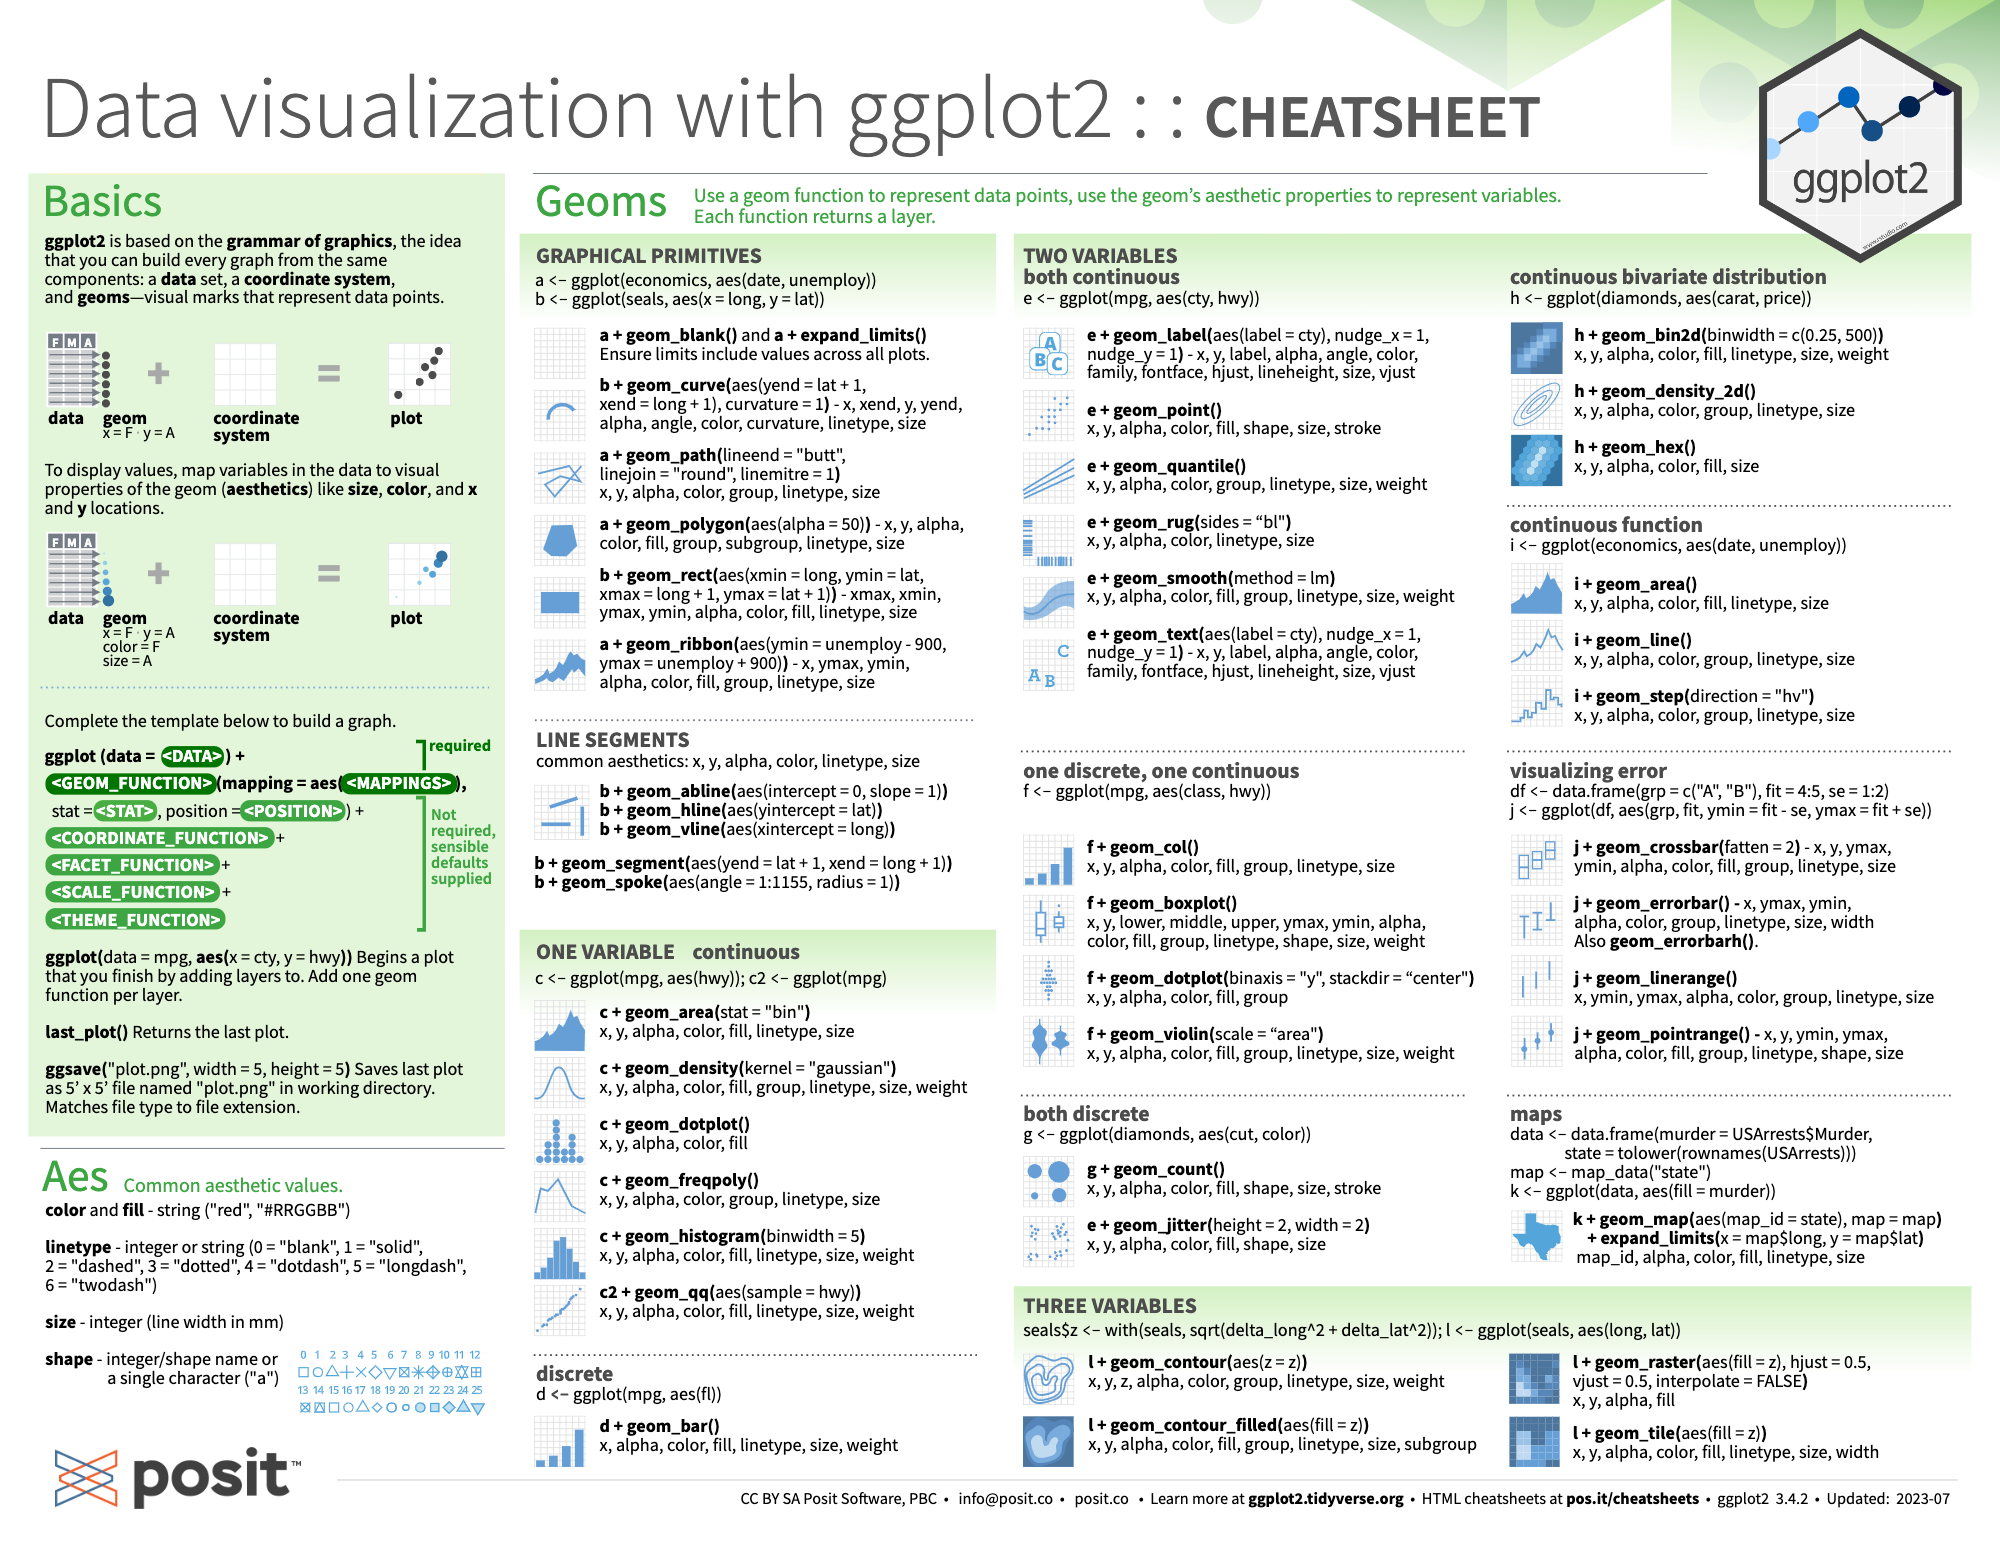
実例も豊富でよくできた公式ウェブサイトを活用しよう
https://ggplot2.tidyverse.org/
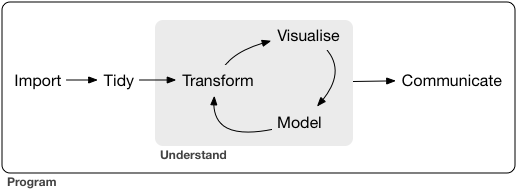
データ解析のおおまかな流れ
- コンピュータ環境の整備
- データの取得、読み込み
- 探索的データ解析
- 前処理、加工 (労力の8割はここという説も)
- 可視化、仮説生成 (まずここを目指す!)
- 統計解析、仮説検証 (みんな重視しがち)
- 報告、発表
機械処理しやすい形 vs 人が読み書きしやすい形
- 作図や解析に使えるデータ形式はほぼ決まってる
ggplot(data, ...),glm(..., data, ...), …- 出発点となるデータはさまざま
- 実験ノート、フィールドノート、データベース、…
Happy families are all alike;
every unhappy family is unhappy in its own way
tidy datasets are all alike,
but every messy dataset is messy in its own way
整然データ tidy data vs 雑然データ messy data
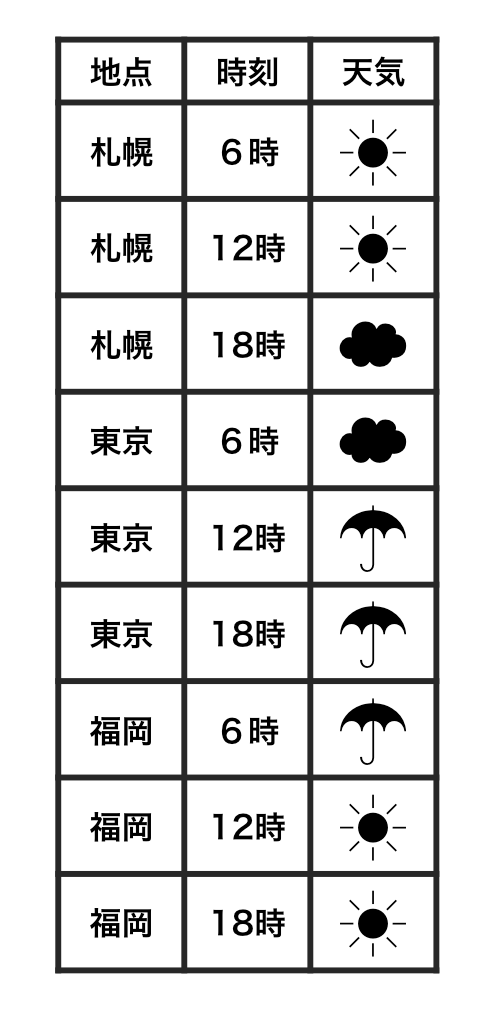
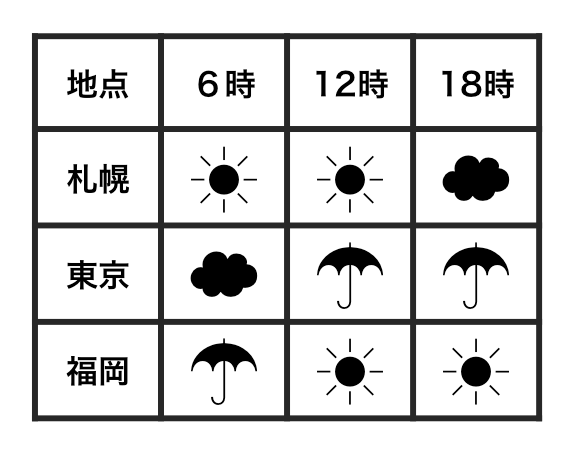
横1行は1つの観測
1セルは1つの値
整然データ tidy data vs 雑然データ messy data
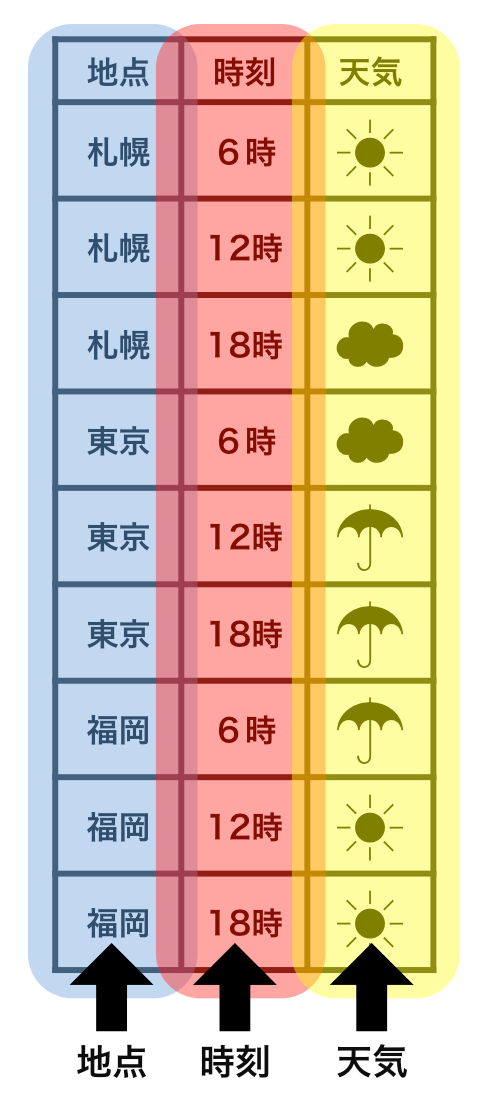
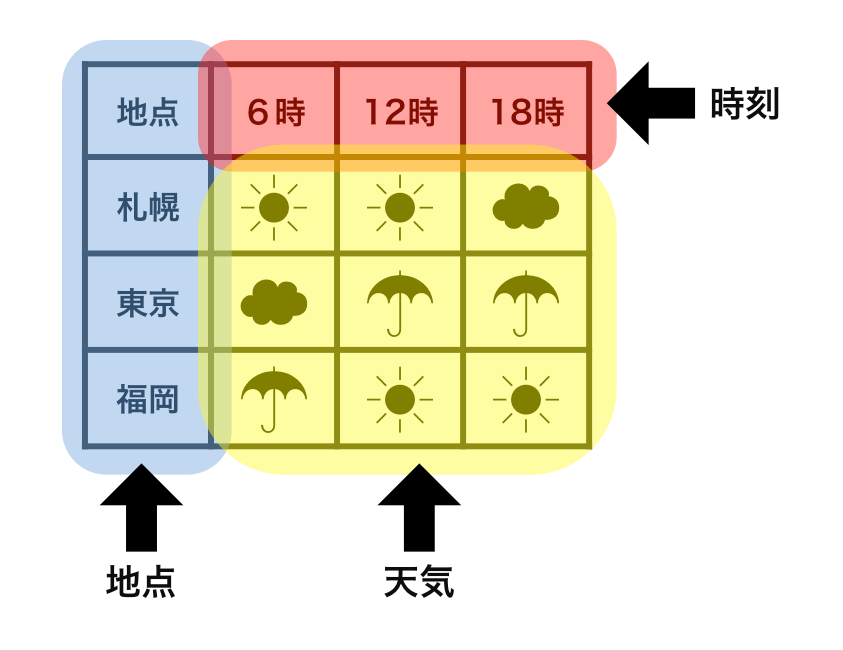
横1行は1つの観測
1セルは1つの値
整然データ tidy data vs 雑然データ messy data
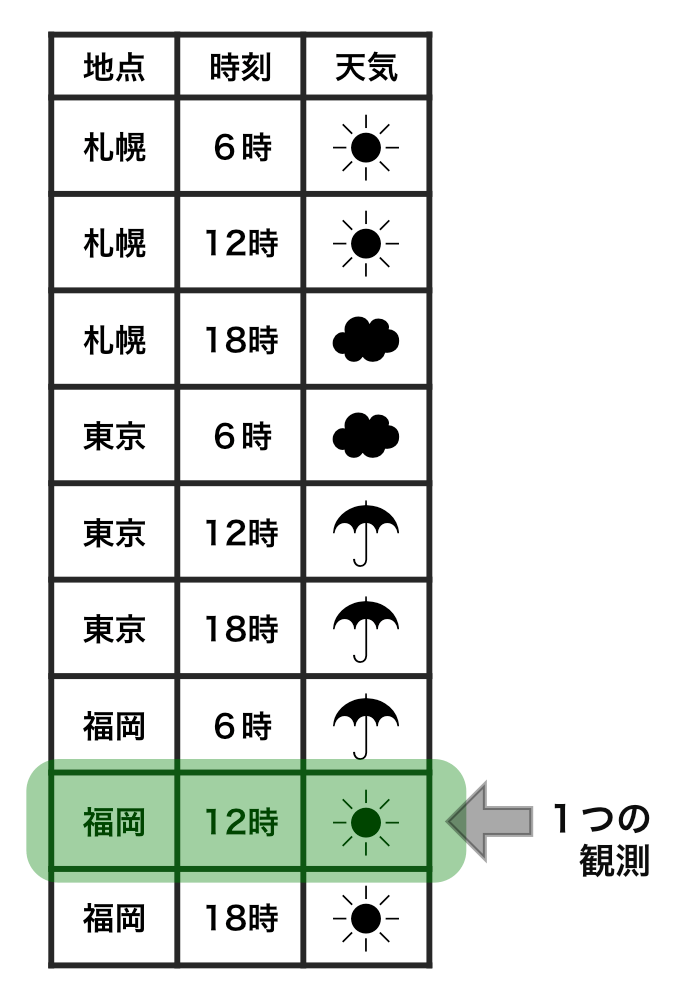
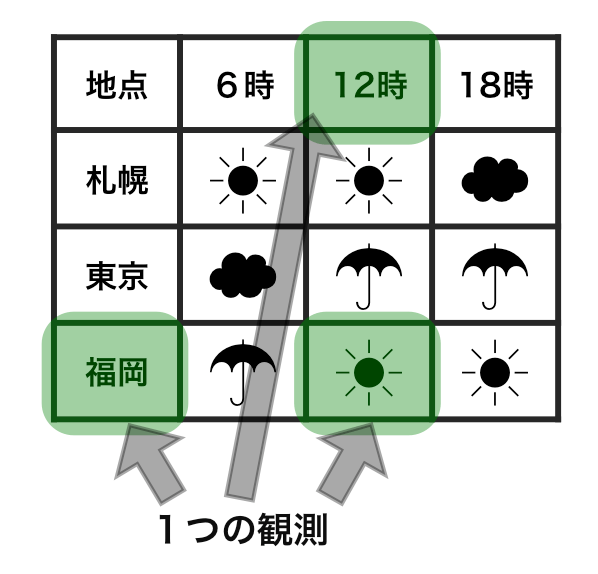
横1行は1つの観測
1セルは1つの値
整然データ tidy data vs 雑然データ messy data
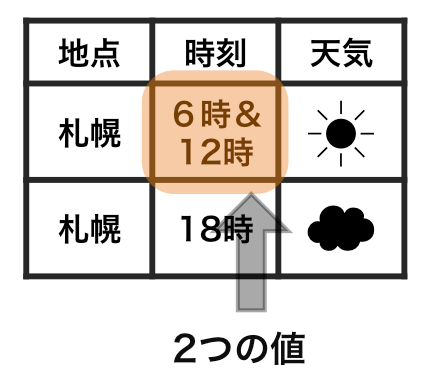
横1行は1つの観測
1セルは1つの値
整然データ tidy data ≈ ggplot したくなる形
- 縦1列は1つの変数
- 横1行は1つの観測
- 1セルは1つの値
https://r4ds.had.co.nz/tidy-data.html
print(ggplot2::diamonds)
      carat       cut color clarity depth table price    x    y    z
    1  0.23     Ideal     E     SI2  61.5    55   326 3.95 3.98 2.43
    2  0.21   Premium     E     SI1  59.8    61   326 3.89 3.84 2.31
    3  0.23      Good     E     VS1  56.9    65   327 4.05 4.07 2.31
    4  0.29   Premium     I     VS2  62.4    58   334 4.20 4.23 2.63
   --
53937  0.72      Good     D     SI1  63.1    55  2757 5.69 5.75 3.61
53938  0.70 Very Good     D     SI1  62.8    60  2757 5.66 5.68 3.56
53939  0.86   Premium     H     SI2  61.0    58  2757 6.15 6.12 3.74
53940  0.75     Ideal     D     SI2  62.2    55  2757 5.83 5.87 3.64
整然データ tidy data ≈ ggplot したくなる形
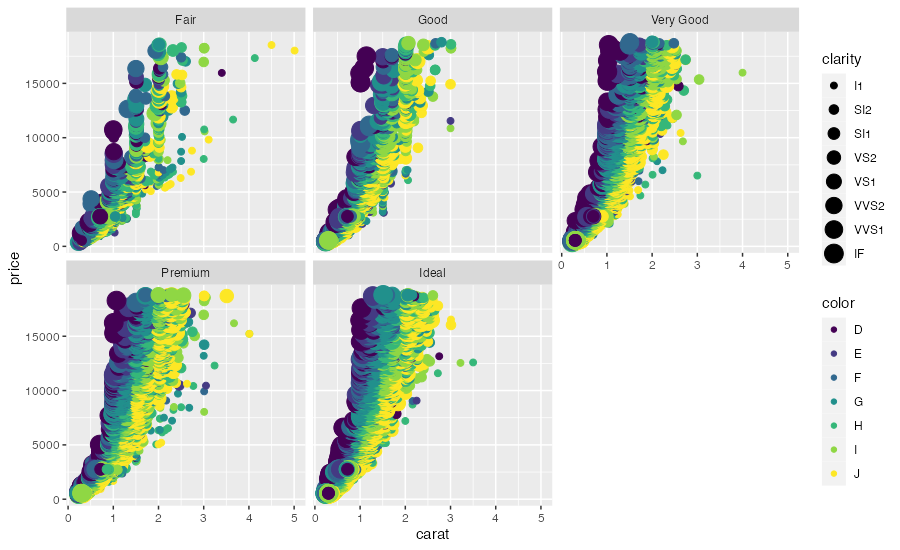
x軸、y軸、色分け、パネル分けなどを列の名前で指定して簡単作図:
ggplot(diamonds) + aes(x = carat, y = price) +
  geom_point(mapping = aes(color = color, size = clarity)) +
  facet_wrap(vars(cut))
前処理: 生データを下ごしらえして食べやすい形に
print(VADeaths)
      Rural Male Rural Female Urban Male Urban Female
50-54       11.7          8.7       15.4          8.4
55-59       18.1         11.7       24.3         13.6
60-64       26.9         20.3       37.0         19.3
65-69       41.0         30.9       54.6         35.1
70-74       66.0         54.3       71.1         50.0
↓ 下ごしらえ: 作図・解析で使いやすい整然データに
   lbound ubound region    sex death
 1     50     54  Rural   Male  11.7
 2     50     54  Rural Female   8.7
 3     50     54  Urban   Male  15.4
 4     50     54  Urban Female   8.4
--
17     70     74  Rural   Male  66.0
18     70     74  Rural Female  54.3
19     70     74  Urban   Male  71.1
20     70     74  Urban Female  50.0
前処理は大きく2つに分けられる
- データ構造を対象とする処理
- 使いたい部分だけ抽出
- グループごとに特徴を要約
- 何かの順に並べ替え
- 異なるテーブルの結合
- 変形: 縦長 ↔ 横広
- データ内容を対象とする処理
- 数値の変換: 対数、正規化
- 外れ値・欠損値への対処
- 型変換: 連続変数、カテゴリカル変数、指示変数、因子、日時
- 文字列処理: 正規表現によるパターンマッチ
dplyr — data.frameの高速処理担当
シンプルな関数がたくさん。繋げて使う (piping)
- 抽出
- 列:
select(), - 行:
filter(),distinct(),slice() - 要約・集計
group_by(),summarize(),count()- 並べ替え
arrange(),relocate()- 列の追加・変更
mutate(),rename()- 結合
- 行方向:
bind_rows() - 列方向:
left_join(),inner_join(),full_join()
dplyrを使ってみる準備
パッケージを読み込んで、データを見てみる
# install.packages("tidyverse")
library(conflicted) # 安全のおまじない
library(tidyverse)
print(diamonds)
View(diamonds)  # RStudio
      carat       cut color clarity depth table price    x    y    z
    1  0.23     Ideal     E     SI2  61.5    55   326 3.95 3.98 2.43
    2  0.21   Premium     E     SI1  59.8    61   326 3.89 3.84 2.31
    3  0.23      Good     E     VS1  56.9    65   327 4.05 4.07 2.31
    4  0.29   Premium     I     VS2  62.4    58   334 4.20 4.23 2.63
   --
53937  0.72      Good     D     SI1  63.1    55  2757 5.69 5.75 3.61
53938  0.70 Very Good     D     SI1  62.8    60  2757 5.66 5.68 3.56
53939  0.86   Premium     H     SI2  61.0    58  2757 6.15 6.12 3.74
53940  0.75     Ideal     D     SI2  62.2    55  2757 5.83 5.87 3.64
🔰 starwars データも眺めてみよう
dplyr の関数を使うときのお作法
名前空間を明示する演算子 :: を使う:
dplyr::filter(diamonds, carat > 3)
   carat     cut color clarity depth table price    x    y    z
 1  3.01 Premium     I      I1  62.7    58  8040 9.10 8.97 5.67
 2  3.11    Fair     J      I1  65.9    57  9823 9.15 9.02 5.98
 3  3.01 Premium     F      I1  62.2    56  9925 9.24 9.13 5.73
 4  3.05 Premium     E      I1  60.9    58 10453 9.26 9.25 5.66
--
29  3.01    Good     H     SI2  57.6    64 18593 9.44 9.38 5.42
30  3.51 Premium     J     VS2  62.5    59 18701 9.66 9.63 6.03
31  3.01 Premium     J     SI2  60.7    59 18710 9.35 9.22 5.64
32  3.01 Premium     J     SI2  59.7    58 18710 9.41 9.32 5.59
同名の関数と衝突する場合(ここではR標準の stats::filter())、
「私が使いたいのは dplyrのほうの filter() です」と明示したい。
そうじゃなくても「この関数はあのパッケージ由来」が分かって便利。
dplyr はこういうふうに使いやすい
小さな関数を繋げて使う流れ作業:
result = diamonds |>                   # 生データから出発して
  dplyr::select(carat, cut, price) |>  # 列を抽出して
  dplyr::filter(carat > 1) |>          # 行を抽出して
  dplyr::group_by(cut) |>              # グループ化して
  dplyr::summarize(mean(price)) |>     # 平均を計算
  print()                              # 表示してみる
        cut mean(price)
1      Fair    7177.856
2      Good    7753.601
3 Very Good    8340.549
4   Premium    8487.249
5     Ideal    8674.227
この見慣れぬ記号 |> は何?
(select() など個々の関数には今日は触れません)
Pipe operator (パイプ演算子) |>
パイプの左側の変数を、右側の関数の第一引数にねじ込む:
diamonds |> dplyr::filter(carat > 1)
dplyr::filter(diamonds, carat > 1)     # これと同じ

# 前処理の流れ作業に便利:
diamonds |> filter(carat > 1) |> select(carat, price) |> ...
potatoes |> cut() |> fry() |> season("salt") |> eat()
🔰 パイプを使わない形に書き換え、出力を確認しよう:
seq(1, 6) |> sum()
[1] 21
letters |> toupper() |> head(3)
[1] "A" "B" "C"
[解答例]
sum(seq(1, 6))
head(toupper(letters), 3)
パイプ演算子 |> を使わない方法
😐 一時変数をイチイチ作る:
tmp1 = dplyr::select(diamonds, carat, cut, price) # 列を抽出して
tmp2 = dplyr::filter(tmp1, carat > 1)             # 行を抽出して
tmp3 = dplyr::group_by(tmp2, cut)                 # グループ化して
result = dplyr::summarize(tmp3, mean(price))      # 平均を計算
😐 同じ名前を使い回す:
result = dplyr::select(diamonds, carat, cut, price) # 列を抽出して
result = dplyr::filter(result, carat > 1)           # 行を抽出して
result = dplyr::group_by(result, cut)               # グループ化して
result = dplyr::summarize(result, mean(price))      # 平均を計算
どちらも悪くない。 何度も変数名を入力するのがやや冗長。
パイプ演算子 |> を使わない方法
😫 一時変数を使わずに:
result = dplyr::summarize(              # 平均を計算
    dplyr::group_by(                        # グループ化して
      dplyr::filter(                            # 行を抽出して
        dplyr::select(diamonds, carat, cut, price), # 列を抽出して
        carat > 1),                             # 行を抽出して
      cut),                                 # グループ化して
    mean(price))                        # 平均を計算
🤪 改行さえせずに:
result = dplyr::summarize(dplyr::group_by(dplyr::filter(dplyr::select(diamonds, carat, cut, price), carat > 1), cut), mean(price))
論理の流れとプログラムの流れが合わず、目が行ったり来たり。
さっきのほうがぜんぜんマシ。
パイプ演算子 |> を使おう
😁 慣れれば、論理の流れを追いやすい:
result = diamonds |>
  dplyr::select(carat, cut, price) |>   # 列を抽出して
  dplyr::filter(carat > 1) |>           # 行を抽出して
  dplyr::group_by(cut) |>               # グループ化して
  dplyr::summarize(mean(price)) |>      # 平均を計算
  print()                               # 表示してみる
        cut mean(price)
1      Fair    7177.856
2      Good    7753.601
3 Very Good    8340.549
4   Premium    8487.249
5     Ideal    8674.227
tidyverseパッケージ群はこういう使い方をしやすい設計。
使わなければならないわけではないが、読めたほうがいい。
R < 4.2 までよく使われていた %>% もほぼ同じ。
tidyr — data.frameの変形・整形担当
- 横広から縦長に
pivot_longer(),gather()- 縦長から横広に
pivot_wider(),spread()- 列を分離、結合
separate(),unite()- 入れ子構造をつくる、解消する
nest(),unnest()
etc.
- こういう変形なしでそのまま使えるデータは激レア
- エクセルでポチポチやらず、tidyrで手続きを記述しよう
- ちょっとハードルは高いけど、使えるようになると強い💪
pivot_longer() 横広から縦長に
複数列にまたがる値を1列にする。
そのラベルも合わせて移動。
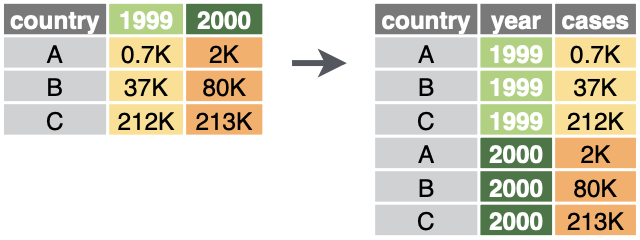
table4a
pivot_longer(table4a, 2:3, names_to = "year", values_to = "cases")
pivot_wider() 縦長から横広に
1列に収まっていた値を複数列の行列に変換。
そのラベルを列の名前にする。
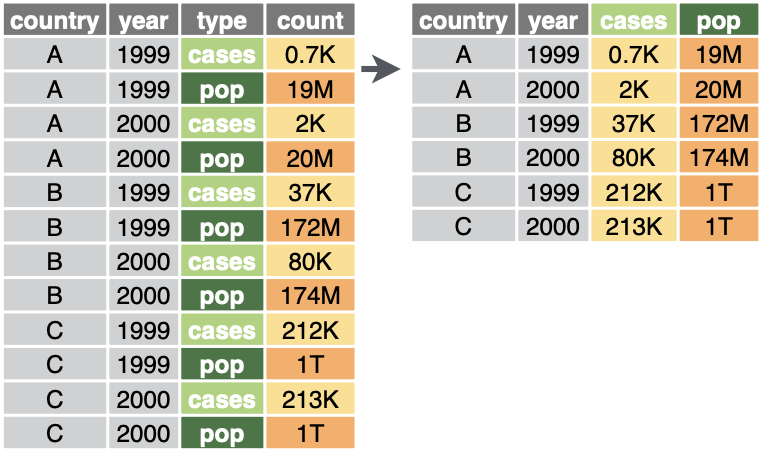
pivot_wider(table2, names_from = type, values_from = count)
Rによるデータ前処理実習は別の講義で
2022年9月に開講。おそらくe-なんとかで視聴可能。
2023年もおそらく同じ時期に開講予定…?
初日のまとめ
✅ まずはデータを可視化して俯瞰しよう
✅ 回帰の統計モデリングに取り組んでいく
✅ Rの基礎
- Rはデータ解析に便利なプログラミング言語・環境
- スクリプトを書いてからコンソールで実行
- 変数には型がある: 数値、文字列、データフレームなど
- 便利なパッケージを使っていく: tidyverse (ggplot2, dplyr, tidyr, etc.)
個々の方法は覚えなくても大丈夫!
忘れては調べ、を何度も繰り返しながら染み込ませていこう。
疑問やエラーの解決方法
- エラーのほとんどは凡ミス由来。よく確認しよう。
- エラー文をちゃんと読む:
No such file or directory - よくあるエラー集 (石川由希さん@名古屋大) をチェックする
- 変数の中身を確かめる:
str(iris),attributes(iris)
- エラー文をちゃんと読む:
- エラー文やパッケージ名をコピペしてウェブ検索
→ StackOverflow や個人サイトに解決策 - Slack
r-wakalang で質問を投稿する。
(質問に飢えた優しいワニが多数生息 👀 👀 👀 👀) - 状況再現できる小さな例
(reprex)
を添えると回答を得やすい。
(これを準備してるうちに問題が切り分けられて自己解決したり) - パッケージの公式ドキュメントをちゃんと読む
- R(Studio)内のヘルプを読む:
?sum,help.start()
参考文献
- R for Data Science — Hadley Wickham and Garrett Grolemund
- https://r4ds.had.co.nz/, Book, 日本語版書籍(Rではじめるデータサイエンス)
- データ解析のための統計モデリング入門 久保拓弥 2012
- データ分析のための数理モデル入門 江崎貴裕 2020
- 分析者のためのデータ解釈学入門 江崎貴裕 2020
- Other versions
- 「進化学実習2023」 東北大学 理学部生物学科 (2023-04)
- 「Rを用いたデータ解析の基礎と応用」 石川由希 2023 名古屋大学
- 「Rによるデータ前処理実習」 東京医科歯科大 データ関連人材育成プログラム (2022-09)
- 「統計モデリング概論 DSHC 2022」 東京海上 DSHC (2022-08)