統計モデリング入門 2025 岩手連大
https://heavywatal.github.io/slides/iwate2025stats/
データを使ってやりたいこと
- 現象を理解したい
- 将来を予測したい
- ものを分類・判別したい
- 挙動を制御したい
- 新しい何かを生成したい
そのために解析は必要? 未加工の生データこそ宝?
データ解析って必要? 生データ見ればいいべ?
往々にして複雑過ぎ、情報多すぎ、そのままでは手に負えない
print(ggplot2::diamonds)
      carat       cut color clarity depth table price    x    y    z
    1  0.23     Ideal     E     SI2  61.5    55   326 3.95 3.98 2.43
    2  0.21   Premium     E     SI1  59.8    61   326 3.89 3.84 2.31
    3  0.23      Good     E     VS1  56.9    65   327 4.05 4.07 2.31
    4  0.29   Premium     I     VS2  62.4    58   334 4.20 4.23 2.63
   --
53937  0.72      Good     D     SI1  63.1    55  2757 5.69 5.75 3.61
53938  0.70 Very Good     D     SI1  62.8    60  2757 5.66 5.68 3.56
53939  0.86   Premium     H     SI2  61.0    58  2757 6.15 6.12 3.74
53940  0.75     Ideal     D     SI2  62.2    55  2757 5.83 5.87 3.64
ダイヤモンド53,940個について10項目の値を持つデータセット
要約統計量を見てみよう
各列の平均とか標準偏差とか:
  stat carat depth table    price
1 mean  0.80 61.75 57.46  3932.80
2   sd  0.47  1.43  2.23  3989.44
3  max  5.01 79.00 95.00 18823.00
4  min  0.20 43.00 43.00   326.00
大きさ carat と価格 price の相関係数はかなり高い:
      carat depth table price
carat  1.00
depth  0.03  1.00
table  0.18 -0.30  1.00
price  0.92 -0.01  0.13  1.00
生のままよりは把握しやすいかも。
分布を特徴づける代表値 central tendency
- 平均値 mean
- 和を観察数で割る
- 中央値 median
- 順に並べて真ん中
- 最頻値 mode
- 最も頻度が高い値
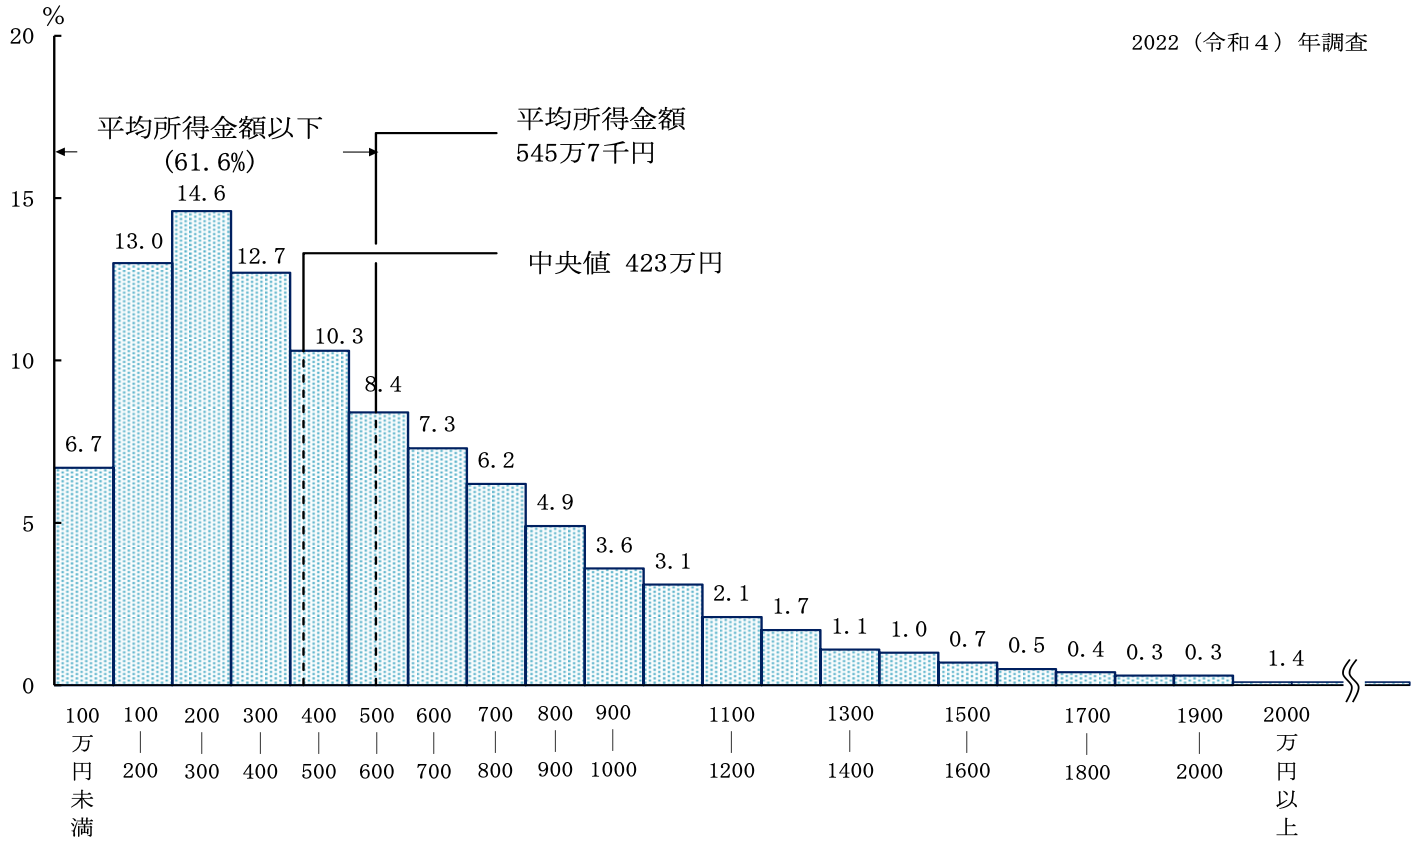
- 外れ値に対する応答
- もし総資産額20兆円の大富豪が鳥取県に引っ越してきたら
→ 県民の平均資産は4000万円上昇。中央値・最頻値はほぼそのまま。
目的や状況に応じて使い分けよう。
ばらつきを捉える記述統計量
- 分散 variance
- 平均値からの差の自乗の平均。 $\frac 1 n \sum _i ^n (X_i - \bar X)^2$
- これの平方根が標準偏差 (standard deviation)。
- Percentile, Quantile (四分位)
- 小さい順にならべて上位何%にあるか。
- 中央値 = 50th percentile = 第二四分位(Q2)

ばらつきの様子は大小の判断にも重要
たまたまかも。
群間の差は微妙か。
AとBには差がありそう。

「こんなことがたまたま起こる確率はすごく低いです!」
をちゃんと示す手続きが統計的仮説検定。
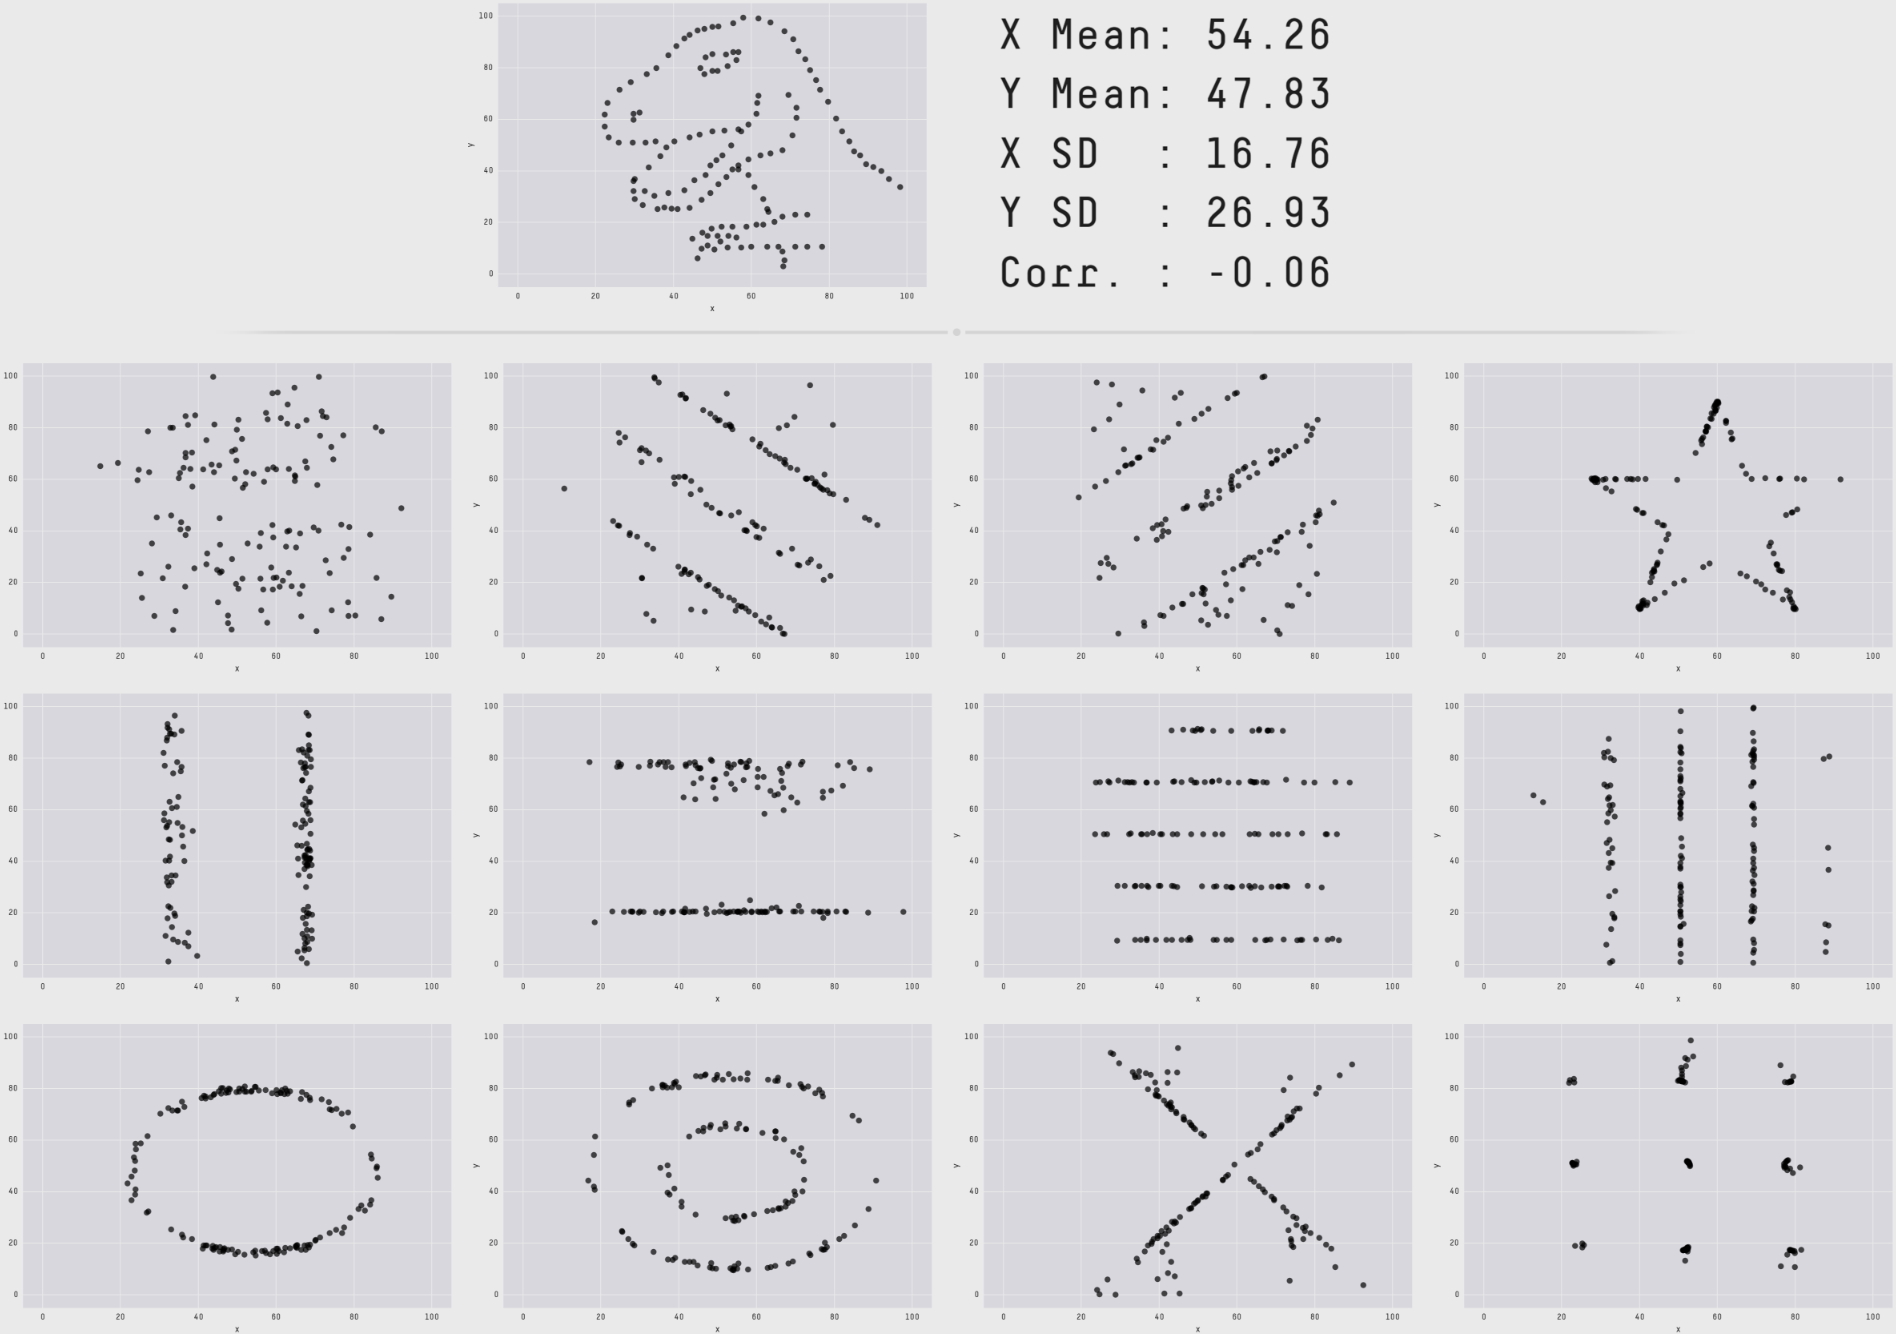
記述統計量に頼りすぎず分布を可視化する
同じデータでも見せ方で印象・情報量が変わる。

代表値ばかり見て可視化を怠ると構造を見逃す
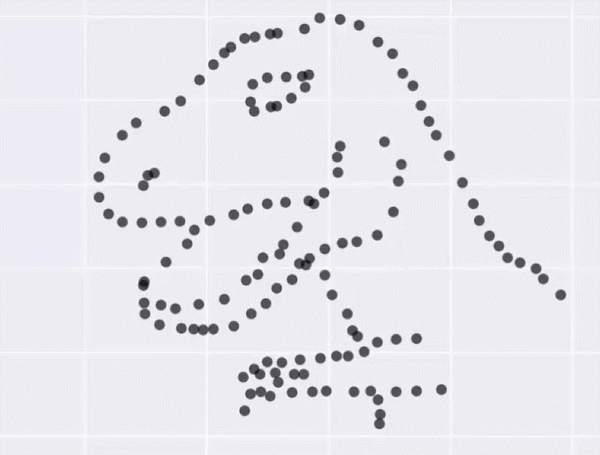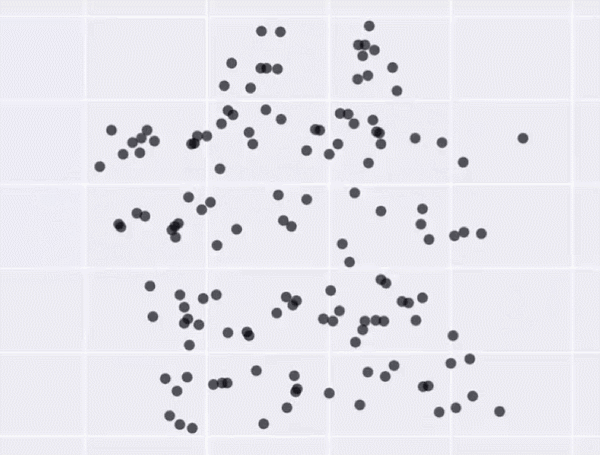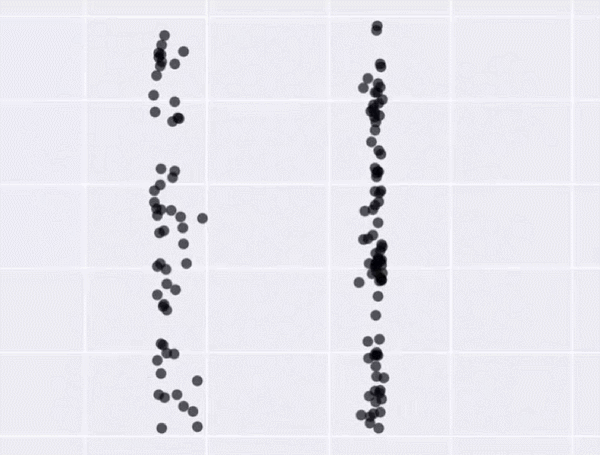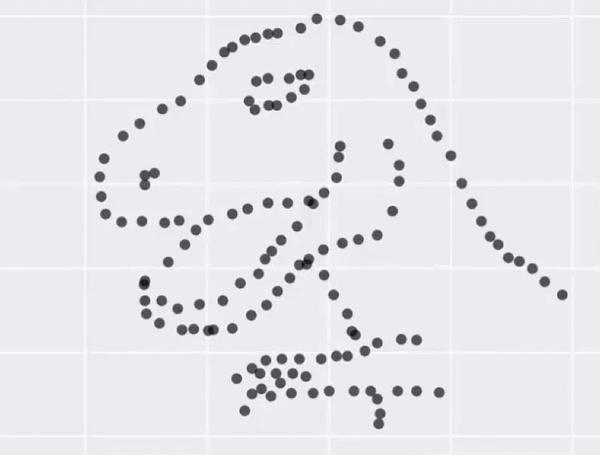
データ可視化は理解の第一歩
情報をうまく絞って整理 → 直感的にわかる

carat が大きいほど price も高いらしい。
その度合いは clarity によって異なるらしい。
統計とは
データをうまくまとめ、それに基づいて推論するための手法。
- 記述統計: データそのものを要約する
- 要約統計量 (e.g., 平均、標準偏差、etc.)
- 作図、作表
- 推測統計: データの背後にある母集団・生成過程を考える
- 数理モデル
- 確率分布
- パラメータ(母数)
「グラフを眺めてなんとなく分かる」以上の分析にはモデルが必要
モデルとは
対象システムを単純化・理想化して扱いやすくしたもの
- Mathematical Model 数理モデル
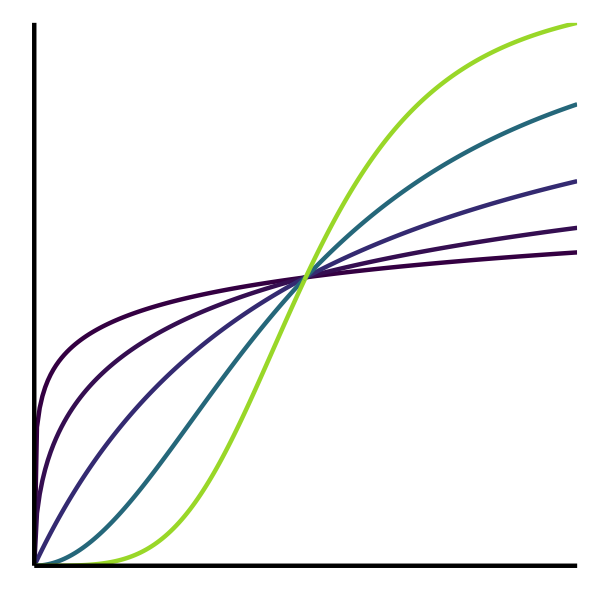
- 数学的な方程式として記述されるもの。
- e.g., Lotka-Volterra eq., Hill eq.
- Computational Model 数値計算モデル
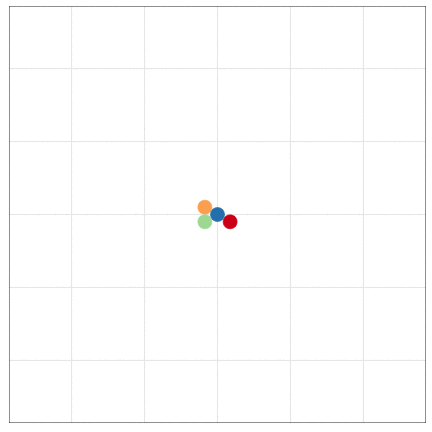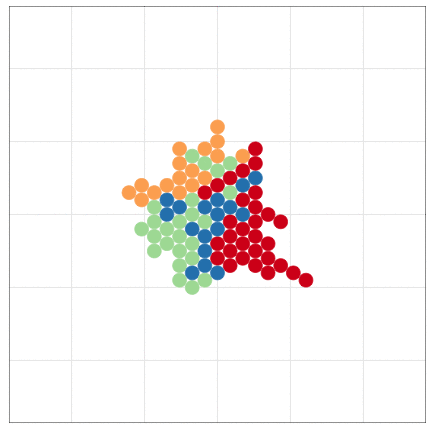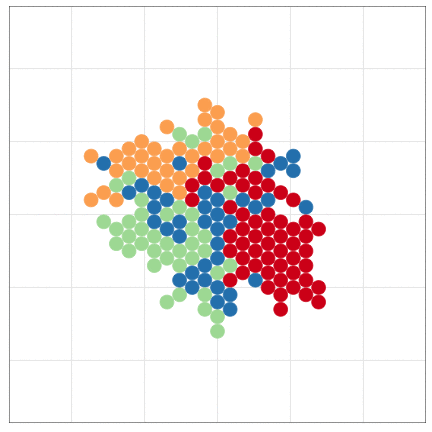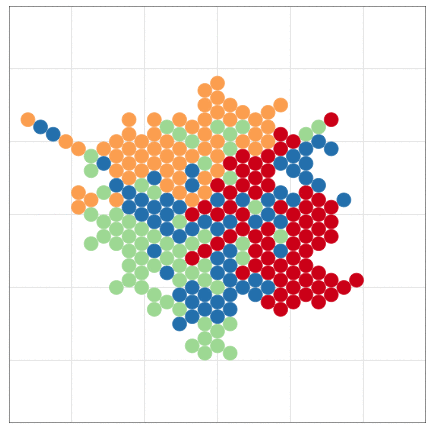
- 数値計算の手続きとして記述されるもの。
- e.g., Schelling’s Segregation Model, tumopp
- Concrete Model 具象モデル
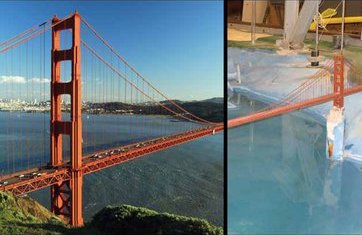
- 具体的な事物で作られるもの。
- e.g., San Francisco Bay-Delta Model
データ科学における数理モデル
データ生成をうまく真似できそうな仮定の数式表現。

データ科学における数理モデル
データ生成をうまく真似できそうな仮定の数式表現。
e.g., 大きいほど高く売れる: $\text{price} = A \times \text{carat} + B + \epsilon$

新しく採れたダイヤモンドの価格予想とかにも使える。
このように「YをXの関数として表す」ようなモデルを回帰と呼ぶ。
本講義の主題: 回帰
単純な直線あてはめから出発し、ちょっとずつ統計モデリング。
何でもかんでも直線あてはめではよろしくない

- 観察データは常に正の値なのに予測が負に突入してない?
- 縦軸は整数。しかものばらつきが横軸に応じて変化?
- データに合わせた統計モデルを使うとマシ
回帰は教師あり機械学習の一種とも言える

でも統計モデリングはいわゆる“機械学習”とは違う気もする…?
モデリングにおける2つのアプローチ

どっちも知っておいて使い分けたい
| 項目 | 統計モデリング | 近年の機械学習 |
|---|---|---|
| モデル構造 | 単純化したい | 性能のためなら複雑化 |
| モデル解釈 | ここが強み | 難しい。重視しない。途上。 |
| 予測・生成 | うまくすれば頑健 | 主目的。強力。高精度 |
| データ量 | 少なくてもそれなり | 大量に必要 |
| 計算量 | 場合による | 場合による |
| 例 | 一般化線形モデル 階層ベイズモデル |
ランダムフォレスト ニューラルネットワーク |
教科書的には概ねこんな感じとして、実際の仕事ではどうだろう?
現役データサイエンティスト2人に聞きました
- 統計モデルはデータ加工など事前の手続きが多め。
機械学習は事前の決定が少ないので楽ちん。 - 「要因の効果はどれくらい?」
意思決定をするのは結局人間。物事を分かった上で判断したい。
実務の人への説明や意思決定の場面で解析の解釈性が重要。 - 仮説があるなら、それに基づいて統計モデリング。
何もないところからまず機械学習で要因抽出・仮説生成するのもあり。 - 統計モデル縛り・実行環境縛りなどの案件もある。
- 分析方針を決める立場の上級職になるつもりなら統計モデルも必要。
協力: @kato_kohakuさん、@teuderさん
本講義のお品書き
久保先生の"緑本"こと
「データ解析のための統計モデリング入門」
をベースに回帰分析の概要を紹介。
- イントロ 👈 いまここ
- 統計モデルの基本
- 直線回帰
- 確率変数・確率分布 👈 本日の主役
- 尤度・最尤推定
- 一般化線形モデル、混合モデル
- ベイズ統計(、階層ベイズモデル)
回帰のキモは線ではなく分布
余裕があれば、手元でRを動かして体感しよう!
- こういう枠が出てきたら、自分のRスクリプトにコピペして保存:
head(iris) - 実行してコンソールを確認。思ったとおりの出力?
ErrorやWarningがあったらよく読んで対処する。 - 🔰若葉マークの練習問題があれば解いてみる。
そこまでのコードのコピペ+改変でできるはず。
Rの基礎、データ前処理、データ可視化などについては別資料を参照:
https://heavywatal.github.io/slides/tohoku2025r/1-introduction.html
Rとは
統計解析と作図の機能が充実したプログラミング言語・環境

- クロスプラットフォーム
- Linux, Mac, Windows で動く
- オープンソース
- 永久に無償で、すべての機能を使える。
- 集合知によって常に進化している。
- コミュニティ
- 相談できる人や参考になるウェブサイトがたくさん見つかる。
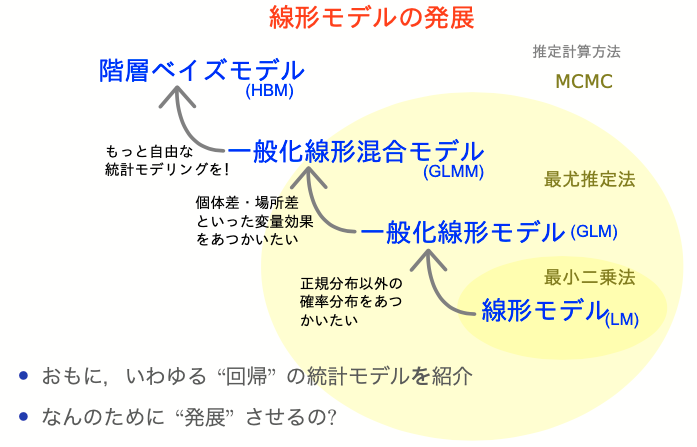
ちょっとずつ線形モデルを発展させていく
線形モデル LM (単純な直線あてはめ)
↓ いろんな確率分布を扱いたい
一般化線形モデル GLM
↓ 個体差などの変量効果を扱いたい
一般化線形混合モデル GLMM
↓ もっと自由なモデリングを!
階層ベイズモデル HBM
「データ解析のための統計モデリング入門」久保拓弥 2012 より改変
直線あてはめ: 統計モデルの出発点
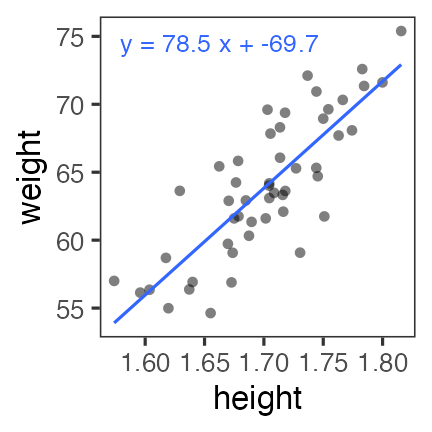
- 身長が高いほど体重も重い。いい感じ。
(説明のために作った架空のデータ。今後もほぼそうです)
回帰モデルの2段階
-
Define a family of models: だいたいどんな形か、式をたてる
- 直線: $y = a_1 + a_2 x$
- 対数: $\log(y) = a_1 + a_2 x$
- 二次曲線: $y = a_1 + a_2 x^2$
-
Generate a fitted model: データに合うようにパラメータを調整
- $y = 3x + 7$
- $y = 9x^2$
たぶん身長が高いほど体重も重い
なんとなく $y = a x + b$ でいい線が引けそう

たぶん身長が高いほど体重も重い
なんとなく $y = a x + b$ でいい線が引けそう
じゃあ傾き a と切片 b、どう決める?

最小二乗法 (Ordinary Least Square: OLS)
回帰直線からの残差平方和(RSS)を最小化する。

残差平方和(RSS)が最小となるパラメータを探せ
ランダムに試してみて、上位のものを採用。
この程度の試行回数では足りなそう。

残差平方和(RSS)が最小となるパラメータを探せ
グリッドサーチ: パラメータ空間の一定範囲内を均等に試す。
さっきのランダムよりはちょっとマシか。

こうした最適化の手法はいろいろあるけど、ここでは扱わない。
これくらいなら一瞬で計算してもらえる
par_init = c(intercept = 0, slope = 0)
result = optim(par_init, fn = rss_weight, data = df_weight)
result$par
intercept     slope
-69.68394  78.53490

上記コードは最適化一般の書き方。覚えなくていい。
回帰が目的なら次ページのようにするのが楽 →
lm() で直線あてはめしてみる
架空のデータを作る(乱数生成については後述):
n = 50
df_weight = tibble::tibble(
  height = rnorm(n, 1.70, 0.05),
  bmi = rnorm(n, 22, 1),
  weight = bmi * (height**2)
)
データと関係式(Y ~ X の形)を lm() に渡して係数を読む:
fit = lm(data = df_weight, formula = weight ~ height)
coef(fit)
(Intercept)      height
  -69.85222    78.63444
せっかくなので作図もやってみる→
lm() の結果をggplotする
df_aug = broom::augment(fit, type.predict = "response")
head(df_aug, 3L)
    weight   height  .fitted    .resid       .hat   .sigma     .cooksd .std.resid
1 63.62151 1.718019 65.24322 -1.621716 0.02187518 3.026731 0.003331001 -0.5457876
2 72.59199 1.782862 70.34213  2.249856 0.06665415 3.017105 0.021454263  0.7751388
3 58.69604 1.617464 57.33617  1.359869 0.07039872 3.029189 0.008345025  0.4694559
ggplot(df_aug) +
  aes(height, weight) +
  geom_point() +
  geom_line(aes(y = .fitted), linewidth = 1, color = "#3366ff")

🔰 ほかのデータでも lm() を試してみよう
fit = lm(data = mpg, formula = hwy ~ displ)
broom::tidy(fit)
         term  estimate std.error statistic       p.value
1 (Intercept) 35.697651 0.7203676  49.55477 2.123519e-125
2       displ -3.530589 0.1945137 -18.15085  2.038974e-46
mpg_aug = broom::augment(fit, type.predict = "response")
ggplot(mpg_aug) + aes(displ, hwy) + geom_point() +
  geom_line(aes(y = .fitted), linewidth = 1, color = "#3366ff")

🔰 diamonds などほかのデータでも lm() を試してみよう。
何でもかんでも直線あてはめではよろしくない
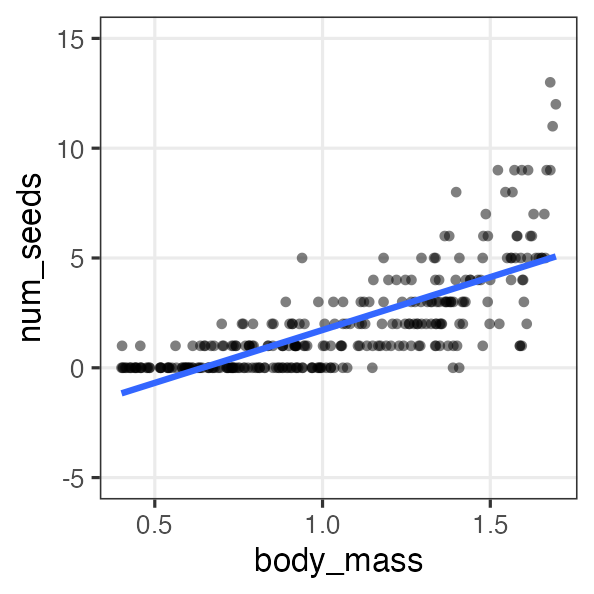
- 観察データは常に正の値なのに予測が負に突入してない?
- 縦軸は整数。しかものばらつきが横軸に応じて変化?
何でもかんでも直線あてはめではよろしくない

- 観察データは常に正の値なのに予測が負に突入してない?
- 縦軸は整数。しかものばらつきが横軸に応じて変化?
- データに合わせた統計モデルを使うとマシ
ちょっとずつ線形モデルを発展させていく
線形モデル LM (単純な直線あてはめ)
↓ いろんな確率分布を扱いたい
一般化線形モデル GLM
↓ 個体差などの変量効果を扱いたい
一般化線形混合モデル GLMM
↓ もっと自由なモデリングを!
階層ベイズモデル HBM
「データ解析のための統計モデリング入門」久保拓弥 2012 より改変
確率分布
発生する事象(値)と頻度の関係。
手元のデータを数えて作るのが経験分布
e.g., サイコロを12回投げた結果、学生1000人の身長

一方、少数のパラメータと数式で作るのが理論分布。
(こちらを単に「確率分布」と呼ぶことが多い印象)
確率変数$X$はパラメータ$\theta$の確率分布$f$に従う…?
$X \sim f(\theta)$
e.g.,
コインを3枚投げたうち表の出る枚数 $X$ は二項分布に従う。
$X \sim \text{Binomial}(n = 3, p = 0.5)$

一緒に実験してみよう。
試行を繰り返して記録してみる
コインを3枚投げたうち表の出た枚数 $X$
試行1: 表 裏 表 → $X = 2$
試行2: 裏 裏 裏 → $X = 0$
試行3: 表 裏 裏 → $X = 1$ 続けて $2, 1, 3, 0, 2, \ldots$

0と3はレア。1と2が3倍ほど出やすいらしい。
コイントスしなくても $X$ らしきものを生成できる
- コインを3枚投げたうち表の出る枚数 $X$
- $n = 3, p = 0.5$ の二項分布からサンプルする乱数 $X$

↓ サンプル
{2, 0, 1, 2, 1, 3, 0, 2, …}
これらはとてもよく似ているので
「コインをn枚投げたうち表の出る枚数は二項分布に従う」
みたいな言い方をする。逆に言うと
「二項分布とはn回試行のうちの成功回数を確率変数とする分布」
のように理解できる。
統計モデリングの一環とも捉えられる
コイン3枚投げを繰り返して得たデータ {2, 0, 1, 2, 1, 3, 0, 2, …}
↓ たった2つのパラメータで記述。情報を圧縮。
$n = 3, p = 0.5$ の二項分布で説明・再現できるぞ
こういうふうに現象と対応した確率分布、ほかにもある?
有名な確率分布、それに「従う」もの
- 離散一様分布
- コインの表裏、サイコロの出目1–6
- 負の二項分布 (幾何分布 if n = 1)
- 成功率pの試行がn回成功するまでの失敗回数
- 二項分布
- 成功率p、試行回数nのうちの成功回数
- ポアソン分布
- 単位時間あたり平均$\lambda$回起こる事象の発生回数
- ガンマ分布 (指数分布 if k = 1)
- ポアソン過程でk回起こるまでの待ち時間
- 正規分布
- 確率変数の和、平均値など。
離散一様分布
同じ確率で起こるn通りの事象のうちXが起こる確率
e.g., コインの表裏、サイコロの出目1–6

🔰 一様分布になりそうな例を考えてみよう
幾何分布 $~\text{Geom}(p)$
成功率pの試行が初めて成功するまでの失敗回数
e.g., コイントスで表が出るまでに何回裏が出るか

\[ \Pr(X = k \mid p) = p (1 - p)^k \]
「初めて成功するまでの試行回数」とする定義もある。
🔰 幾何分布になりそうな例を考えてみよう
負の二項分布 $~\text{NB}(n, p)$
成功率pの試行がn回成功するまでの失敗回数X。 n = 1 のとき幾何分布と一致。
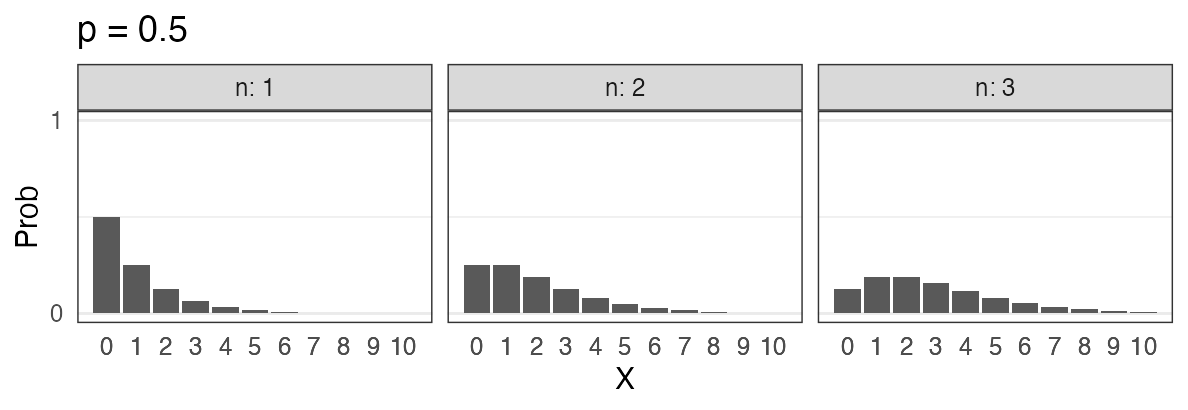
\[ \Pr(X = k \mid n,~p) = \binom {n + k - 1} k p^n (1 - p)^k \]
失敗回数ではなく試行回数を変数とする定義もある。
🔰 負の二項分布になりそうな例を考えてみよう
二項分布 $~\text{Binomial}(n,~p)$
確率$p$で当たるクジを$n$回引いてX回当たる確率。平均は$np$。

\[ \Pr(X = k \mid n,~p) = \binom n k p^k (1 - p)^{n - k} \]
🔰 二項分布になりそうな例を考えてみよう
ポアソン分布 $~\text{Poisson}(\lambda)$
平均$\lambda$で単位時間(空間)あたりに発生する事象の回数。
e.g., 1時間あたりのメッセージ受信件数、メッシュ区画内の生物個体数

\[ \Pr(X = k \mid \lambda) = \frac {\lambda^k e^{-\lambda}} {k!} \]
二項分布の極限 $(\lambda = np;~n \to \infty;~p \to 0)$。
めったに起きないことを何回も試行するような感じ。
指数分布 $~\text{Exp}(\lambda)$
ポアソン過程の事象の発生間隔。平均は $1 / \lambda$ 。
e.g., メッセージの受信間隔、道路沿いに落ちてる手袋の間隔

\[ \Pr(x \mid \lambda) = \lambda e^{-\lambda x} \]
幾何分布の連続値版。
🔰 ポアソン分布・指数分布になりそうな例を考えてみよう
ガンマ分布 $~\text{Gamma}(k,~\lambda)$
ポアソン過程の事象k回発生までの待ち時間
e.g., メッセージを2つ受信するまでの待ち時間

\[ \Pr(x \mid k,~\lambda) = \frac {\lambda^k x^{k - 1} e^{-\lambda x}} {\Gamma(k)} \]
指数分布をkのぶん右に膨らませた感じ。
shapeパラメータ $k = 1$ のとき指数分布と一致。
正規分布 $~\mathcal{N}(\mu,~\sigma)$
平均 $\mu$、標準偏差 $\sigma$ の美しい分布。よく登場する。
e.g., $\mu = 50, ~\sigma = 10$ (濃い灰色にデータの95%, 99%が含まれる):

\[ \Pr(x \mid \mu,~\sigma) = \frac 1 {\sqrt{2 \pi \sigma^2}} \exp \left(\frac {-(x - \mu)^2} {2\sigma^2} \right) \]
正規分布に近づくものがいろいろある
標本平均の反復(中心極限定理); e.g., 一様分布 [0, 100) から40サンプル

大きい$n$の二項分布

正規分布に近づくものがいろいろある
大きい$\lambda$のポアソン分布

平均値固定なら$k$が大きくなるほど左右対称に尖るガンマ分布

有名な確率分布対応関係ふりかえり
- 離散一様分布
- コインの表裏、サイコロの出目1–6
- 負の二項分布 (幾何分布 if n = 1)
- 成功率pの試行がn回成功するまでの失敗回数
- 二項分布
- 成功率p、試行回数nのうちの成功回数
- ポアソン分布
- 単位時間あたり平均$\lambda$回起こる事象の発生回数
- ガンマ分布 (指数分布 if k = 1)
- ポアソン過程でk回起こるまでの待ち時間
- 正規分布
- 確率変数の和、平均値。使い勝手が良く、よく登場する。
現実には、確率分布に「従わない」ことが多い
植物100個体から8個ずつ種子を取って植えたら全体で半分ちょい発芽。
親1個体あたりの生存数はn=8の二項分布になるはずだけど、
極端な値(全部死亡、全部生存)が多かった。
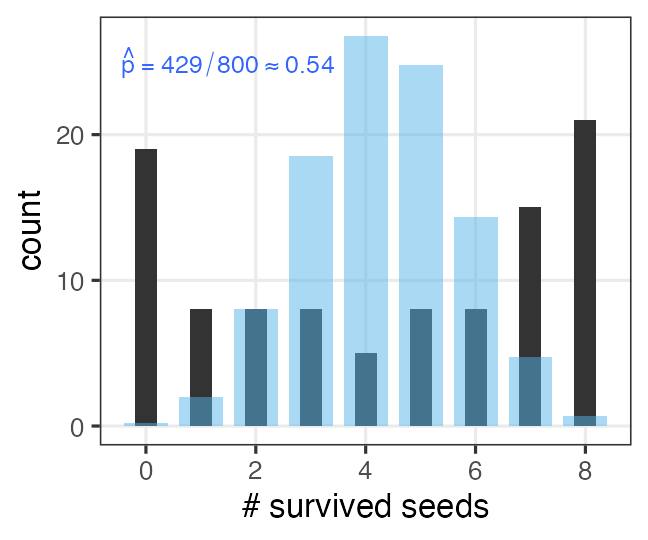
「それはなぜ?」と考えて要因を探るのも統計モデリングの仕事。
「普通はこれに従うはず」を理解してこそできる思考。
疑似乱数生成器 Pseudo Random Number Generator
コンピューター上でランダムっぽい数値を出力する装置。
実際には決定論的に計算されているので、
シード(出発点)と呼び出し回数が同じなら出る数も同じになる。
set.seed(42)
runif(3L)
# 0.9148060 0.9370754 0.2861395
runif(3L)
# 0.8304476 0.6417455 0.5190959
set.seed(42)
runif(6L)
# 0.9148060 0.9370754 0.2861395 0.8304476 0.6417455 0.5190959
シードに適当な固定値を与えておくことで再現性を保てる。
ただし「このシードじゃないと良い結果が出ない」はダメ。
さまざまな「分布に従う」乱数を生成することもできる。
いろんな乱数を生成・可視化して感覚を掴もう
n = 100
x = sample.int(6, n, replace = TRUE)  # 一様分布(整数)
x = runif(n, min = 0, max = 1)        # 一様分布
x = rgeom(n, prob = 0.5)              # 幾何分布
x = rbinom(n, size = 5, prob = 0.5)   # 二項分布
x = rpois(n, lambda = 2.1)            # ポアソン分布
x = rnorm(n, mean = 50, sd = 10)      # 正規分布
print(x)

p1 = ggplot(data.frame(x)) + aes(x)
p1 + geom_histogram() # for continuous values
p1 + geom_bar()       # for discrete values
🔰 正規分布の n, mean, sd を変えて作図し、それぞれの影響を確認しよう。
🔰 ポアソン分布の n, lambda を変えて作図し、それぞれの影響を確認しよう。
🔰 1%の当たりを狙って10連ガチャを回す人が100万人いたら、
全部はずれ、1つ当たり、2つ当たり… の人はどれくらいいるか?
本講義のお品書き
久保先生の"緑本"こと
「データ解析のための統計モデリング入門」
をベースに回帰分析の概要を紹介。
- イントロ
- 統計モデルの基本
- 直線回帰
- 確率変数・確率分布 👈 ここまでやった
- 尤度・最尤推定
- 一般化線形モデル、混合モデル
- ベイズ統計(、階層ベイズモデル)
回帰のキモは線ではなく分布
参考文献
- データ解析のための統計モデリング入門 久保拓弥 2012
- StanとRでベイズ統計モデリング 松浦健太郎 2016
- RとStanではじめる ベイズ統計モデリングによるデータ分析入門 馬場真哉 2019
- データ分析のための数理モデル入門 江崎貴裕 2020
- 分析者のためのデータ解釈学入門 江崎貴裕 2020
- 統計学を哲学する 大塚淳 2020
- 「進化学実習2025」 東北大学 理学部生物学科 (2025-04)
- 「Rを用いたデータ解析の基礎と応用」 石川由希 2024 名古屋大学
- 「統計モデリング概論 DSHC 2024」 東京海上 DSHC (2024-08)